归档 / NO.012 · 本地 AI · ASR · TTS · ESP32 · 喵伴 · VoiceHub
从 ESP32 到 Mac 本地 VoiceHub:一条能开口说话的本地链路
把喵伴接到 Mac 上的本地「听 → 想 → 说」,再补上听声转头。按实机与仓库验证写边界;文末一步步带你先在本机跑通。
本文章节 · CONTENTS 10
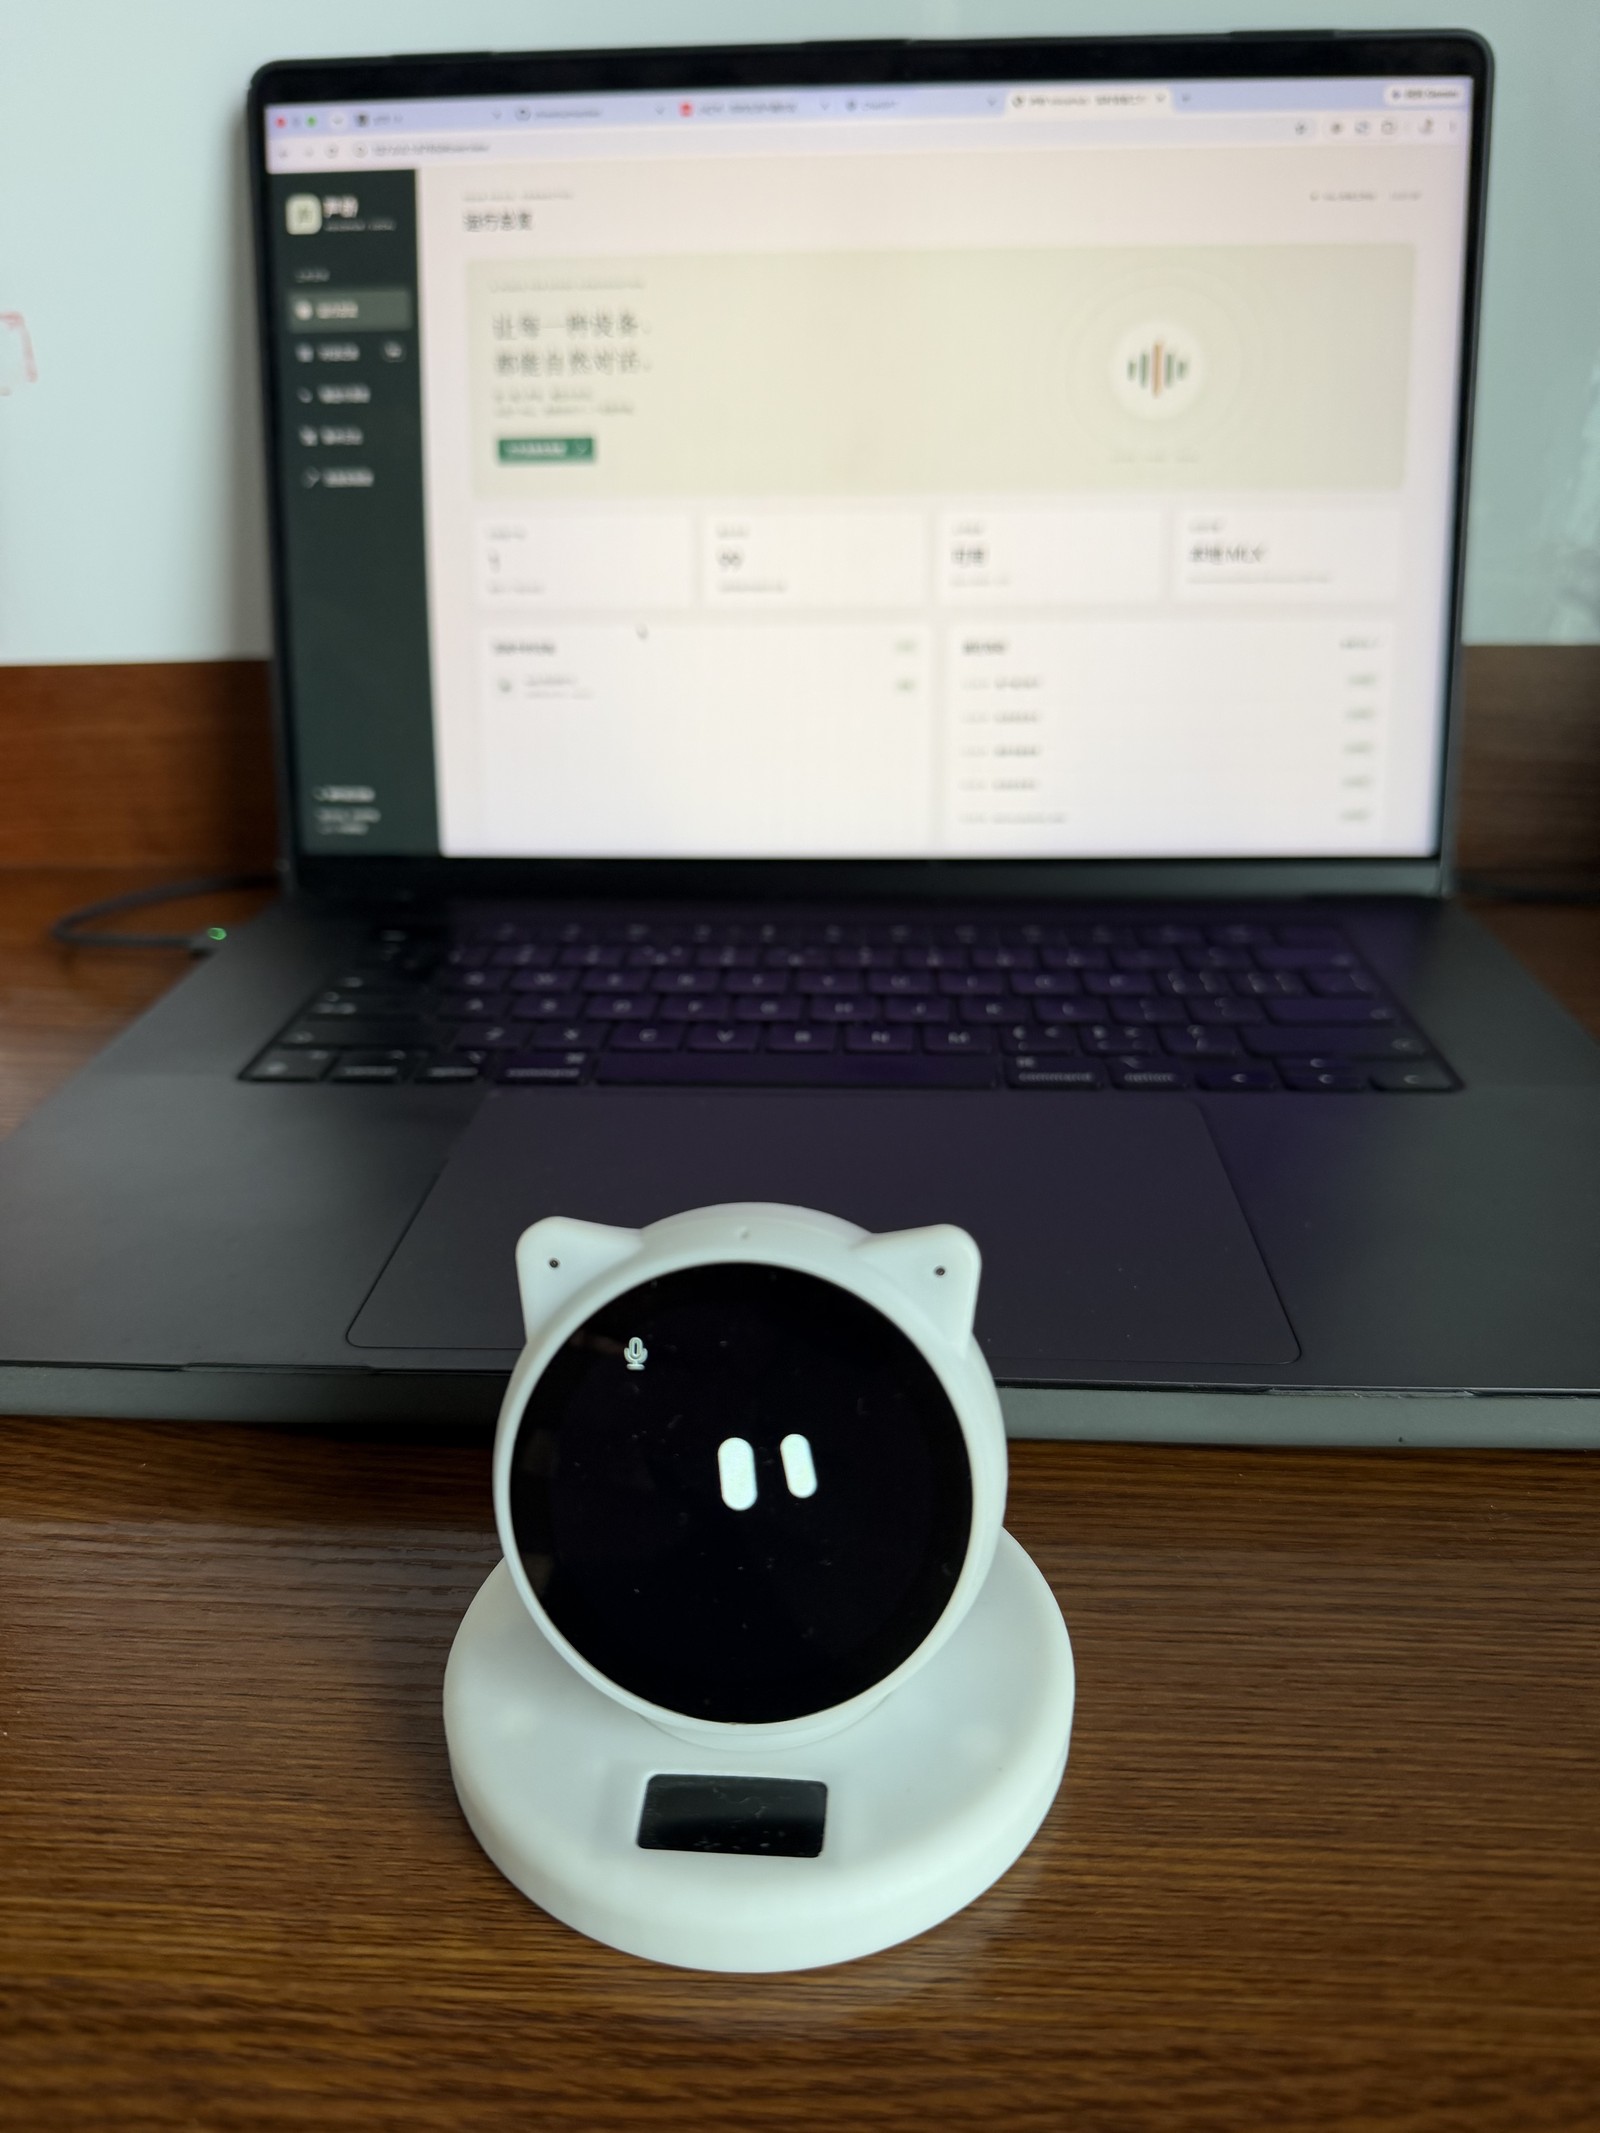
我手上有一只喵伴:猫头能听、能亮眼睛、能出声,底座能带着头转。我想让它用我自己 Mac 上的模型——喊一声「小宝同学」,它听懂、想好、再用我选的声音说出来;旁边有人说话时,还能朝声源转一下头。
做下来才发现:最花时间的往往不是写代码,而是让设备、后台、模型和电机的状态对齐。什么叫「状态对不齐」?举两个我撞过的现场就够了。
一个是安静的机器人:你刚聊完,控制台里已经跳出了完整回答,字都齐了,猫头却一声不吭——像后台已经写好了台词,演员没接到开麦信号。另一个是卡住的转头:麦克风明明听得见旁人说话,底座却报堵转保护,头一动不动——听的那一层正常,转的那一层自己停了。每一层都显示「正常」,不等于整条链路真通了。
源码在 zhiwehu/miaoban(0.1 源码发布)。文里的数字来自仓库 docs/VALIDATION.md、仓库中文技术文和实机复听,是单次观测,不作跨机器承诺。文末有一段「跟着做」:没有喵伴也能先在 Mac 上把「听 → 想 → 说」跑通。
1. 为什么要把「大脑」放在本机
云端语音助手很省事:你说话,云端听、云端想、云端合成声音,再传回来。我还是把推理放在本机,主要就三点:
- 隐私: 正常对话时,语音在本机完成「听成字 → 想回答 → 合成声」,不必把每一句都交给云端模型。
- 可控: 哪一步慢了、哪一轮该取消、日志里卡在哪一层,都能自己改、自己查。
- 延迟可摸: 负载一高,是「听」慢了、「想」慢了,还是「说」慢了,在自己机器上比猜云端排队清楚。
有两句要事先拆开,不然后面容易误会:
- 「本地推理」≠「整机永不联网」。 模型第一次下载、固件去哪找更新、设备从哪拿配置,仍要你显式指定。我这边的运行适配器只读已经下好的模型;设备也可以把更新地址指回本地后台——这是配置选择,不是魔法。
- 「实时对话」≠「已经验收的自然插话」。 协议能双向传声音,不等于机器人正在说话时,你随时插嘴都自然。仓库写得很直:真实外放场景下的回声消除(AEC)和自然打断,还没验收完。
2. 硬件分工:猫头、Mac、底座
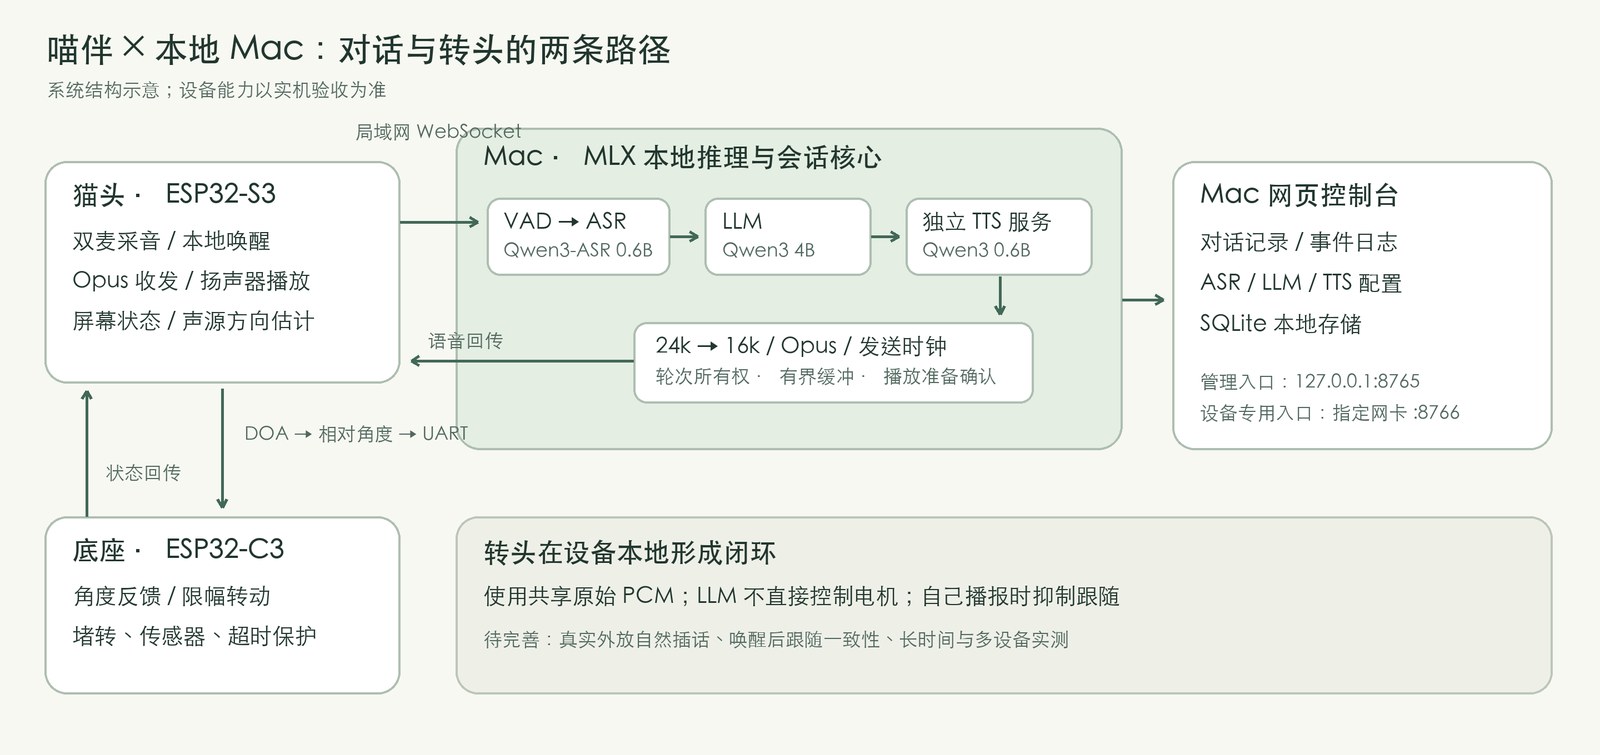
实现拆成三块,各管各的。可以先记成一句话:猫头脑袋负责听和说,Mac 负责想,底座负责转。
| 部分 | 干什么(白话) |
|---|---|
| ESP32-S3 猫头 | 两颗麦采音、本机喊「小宝同学」唤醒、把声音编码后发出去、喇叭播放、屏幕表情、估计声音从哪边来 |
| Apple Silicon Mac | 判断你说完了没有、听成文字、生成回答、合成语音、管会话、给一个本机网页控制台 |
| ESP32-C3 底座 | 读当前角度、在有限幅度里转头、堵转 / 超时 / 限幅保护 |
里头的芯片叫 ESP32,可以把它理解成「猫头 / 底座里那颗专门跑嵌入式程序的小电脑」——负责实时采音、播放和转头,不负责跑大模型。
猫头和 Mac 走同一局域网。接入方式现在可以选两种(下面会细说):一种是 WebSocket,控制和声音走同一条连接;另一种是 MQTT 管控制信号,声音另走 UDP。两种入口背后共用同一套会话、模型和记录逻辑。设备入口要令牌;管理网页只听本机回环(127.0.0.1),不对外。声源定位和电机走设备本地串口:大模型不直接决定舵机转多少度——它负责回话,转头是设备自己的事。
文中测试机是 M4 Max / 128GB 统一内存。这是观测环境,不是项目最低配置;别的芯片、内存和后台负载都会改延迟。
架构示意见仓库 media/architecture.png(示意图,非实拍宣传图)。

3. 软件链路:听 → 想 → 说
先用大白话过一遍,再对上缩写:
- 听: 把你说的话变成文字。业界常叫 ASR(Automatic Speech Recognition)。
- 想: 根据会话历史生成回答。业界常叫 LLM(大语言模型)。
- 说: 把回答合成能播出的声音。业界常叫 TTS(Text-to-Speech)。
中间还有一步 VAD:判断「这段是不是人声、你是不是说完了」,好把一整句切出来再交给「听」。没有它,系统不知道何时该开始认真识别。
本机这套后台,仓库里叫 VoiceHub(声桥):专门把设备和本地模型接起来。当前公开配置(见仓库文章与依赖说明):
| 环节 | 模型 | 怎么跑 |
|---|---|---|
| 听(ASR) | mlx-community/Qwen3-ASR-0.6B-8bit | MLX Audio(Apple 芯片上跑音频模型) |
| 想(LLM) | mlx-community/Qwen3-4B-Instruct-2507-4bit | MLX LM |
| 说(TTS) | mlx-community/Qwen3-TTS-12Hz-0.6B-CustomVoice-8bit | 独立常驻的 MLX 进程 |
| 音色 | Serena 等 CustomVoice 预设 | 中文试听可用 |
联调早期我先用过 macOS 自带的系统语音(界面里常见名字 Tingting),少一个「神经 TTS」变量:先确认识别、回答、音频格式、设备播放都能串起来,再换成 Qwen TTS。这样出问题的时候,更容易判断是「模型不行」还是「链路没接好」。
一句话怎么走:
双麦采音 → 网络接入层 → VAD 分句 → 本地听(ASR)
                                    ↓
                             会话历史 → 本地想(LLM)
                                    ↓
                        分句 → 本地说(TTS) → 重采样(如 24k→16k)
                                    ↓
                         网络接入层 → 扬声器

网络接入层:WebSocket,或 MQTT 控制消息 + UDP 音频
几点取舍,用场景说比堆术语清楚:
- 听主要处理已经切好的一句,不是你还在说、屏幕上就一个字一个字往外蹦。所以「实时对话」指的是持续连接、自动接话、边生成边播的体验,不等于完整的「说话时随时插嘴都自然」。
- 说和听 / 想分进程跑,避免挤在同一个工作队列里互相等;但它们仍共享同一颗 Apple Silicon GPU——进程分开 ≠ 算力分开。你一边生图一边聊,TTS 照样会被拖慢。
- 接口可以换成兼容的 HTTP 服务;本文实测跑的是本地模型。
- 后台区分设备、会话、连接与每一轮回答的编号(
turn_id):你打断旧轮之后,迟到的文字或音频不能灌进新轮。控制台里「已生成」只说明模型出完了;没有播放确认,就不能写成「用户已听到」。MQTT 控制连接可以一直在线,也不代表某个语音会话必须一直占着「聆听」——连着线和正在听你说话,是两件事。
我也做了一个本机网页控制台:看已识别文字、回答、连接状态、轮次耗时和错误,也能改听 / 想 / 说的配置。只有串口日志时,很难判断一次无声究竟卡在「没识别」「没生成」还是「生成了但没播出去」。
4. 实测:通了什么,慢在哪
已确认
- 本地听 → 想 → 说,能完成设备上的实机对话;用户复听确认 Qwen + Serena 当前可用。
- 默认分支侧:后端约 49 项自动化测试;底座 / 方向等逻辑另有 9 个可在主机跑的 C++ 测试。加入 MQTT 后的实现版本,仓库技术文记为 67 项后端测试(见下文边界)。
- 待机听声转头已有实机反馈;底座曾报
STALL=2(堵转),检查受阻并重新上电后故障清零、转头恢复。 - 0.1 源码发布时,猫头与底座固件在干净临时目录下可完成构建(见
VALIDATION.md)——这验证的是快照可构建,不等于与某一历史上游提交逐字节对应。
延迟(单次观测,不是 A/B)
| 观测 | 结果 |
|---|---|
| 较低负载单句 Qwen TTS | 约 3.36 s 音频 / 2.05 s 生成,首包约 522 ms,RTF≈0.61(生成快于实时播放) |
| 相近长度、并行负载更高 | 生成约 10 s——边生成边播容易「断粮」(播到一半后面还没造出来) |
| LLM→Qwen→16k→Opus→WS 模拟接收 | 约 4.5 s 音频、75 包;模拟缓冲断粮 0 次 |
TTS 首包不是「你说完到机器人出声」的总延迟。 总延迟还要算:等你说完(VAD)、听成字、想回答、播放准备握手和缓冲。负载一上来,0.6B 的小模型也会明显变慢——别把它理解成「永远固定多少毫秒」。
换成 MQTT,接话会不会更快?
后续调试时我问过自己:ESP32 圈子里很常见 MQTT,换掉 WebSocket 会不会更快?于是给后台加了 MQTT 管控制、UDP 传声音 的入口,并在同一只喵伴上对照。
先把「MQTT 模式」说准确,免得听成「所有声音都塞进 MQTT」:
- 控制消息(打招呼、开始听、开始/停止播放等)走 MQTT;
- Opus 音频走单独的 UDP 通道;
- 听 / 想 / 说、会话历史、取消逻辑继续共用,换的只是传输适配层。
示意:
WebSocket:猫头 ←── 控制 + 声音 ──→ Mac 后台

MQTT+UDP:猫头 ←── MQTT 控制 ──→ 本地 Broker ←──→ Mac 后台
              ←────── UDP / Opus 声音 ──────→
我用本机 Mosquitto 当 Broker,给后台和每台设备不同账号,用 Topic 权限限制谁能发、谁能订。MQTT 配网用每台设备独立的令牌,并核对身份;原来的 WebSocket 设备令牌不能直接拿来当 MQTT 凭据。局域网联调配置里,UDP 用的加密格式没有消息认证标签,MQTT/HTTP 也没开 TLS——所以只适合受信任的本地网,不能当成可以裸奔公网的方案。
排除模型之后的软件测量(同一台 Mac、同一局域网,去预热后):会话握手中位数 WebSocket 约 3.11 ms、MQTT+UDP 约 1.47 ms;控制消息往返则是 WebSocket 略快(约 0.57 ms vs 1.47 ms)。都是毫秒级,解释不了几秒级的接话等待。实机两边都能正常回话,主观听感「差别不明显」;冷启动第一轮仍可能要好几秒,大头在识别和模型准备,不在换协议本身。
结论要收窄写:两种协议都能用;现有对照还不足以说「换成 MQTT 就会稳定提速」。 对照后我把喵伴恢复为 MQTT+UDP,WebSocket 入口继续保留。按仓库技术文更新时的说明,MQTT 实现与完整测试记录在 PR #1,当时尚未合入默认分支——上面描述对应本机已部署并测过的版本;你若只按默认分支 README 起步,先走 WebSocket 即可,不必为了「更快」硬切。
5. 两个翻车现场
安静约十五秒后:有字无声
连续聊能听见;静一会儿再说话,后台仍识别、仍生成,猫头却没声。再说一句,有时又恢复。第一反应很容易是:「音频模型是不是自动退出了?」
我没有继续拧音量或反复换模型,而是读了固件的电源管理路径。设备大约会在 15 秒没有播放后关掉音频输出,时间点和现象对得上。
原来的播放流程在重新开输出时,还沿用上次播放的活动时间。电源定时器和开启流程之间存在竞争:新打开的输出,可能被「旧的超时判断」再次关掉。另外,猫头收到「开始播放」,只是把状态切换排进主任务——不等于解码器已经重置、喇叭已经准备好收音频。
修法两层:
- 开输出前先刷新活动时间;输出开启和定时关闭用同一把锁。
- 加播放准备握手——猫头切到「正在说」、重置解码器并恢复输出后,回一句
tts.ready;后台核对轮次与状态,再发包。
复听里两轮曾分别收到 40 / 70 个音频包,解码与播放计数跟上,状态丢包为 0。这证明这条路径值得保留,不证明所有休眠周期都验完了。
你自己排查时:别先换模型。 先看设备有没有回 tts.ready,以及收包 / 解码 / 播放计数有没有涨——字出来了但计数不涨,多半是「说」没真正进喇叭,不是「想」没想出来。
后台已待机,猫头还在「聆听」
小宝有几个很直观的画面:只显示眼睛的待机、眼睛上方竖条变化的聆听,以及显示文字的对话画面。画面能帮使用者理解状态;开发时仍要看实际状态机——屏幕说「聆听」,不代表后台还愿意收你的音。
我遇到过:长时间没说话后,猫头还保持聆听画面。直接和它说话不理,再喊「小宝同学」也无法唤醒。
原因是后台默认在空闲约 30 秒后进入 standby(待机),却没有把这次状态变化同步到旧协议设备。猫头留在 Listening,关了本地唤醒;后台又会丢弃设备模式下 standby 时上传的音频——两端一起卡住:一边以为还在听,一边已经不收了。
旧协议没有统一的 standby 指令。处理要按接入方式分开说:
- WebSocket: 超时后关闭当前对话连接;猫头用已有的断线回调回到 Idle,恢复本地唤醒。下次唤醒再连。
- MQTT: 发送 goodbye,关掉当前音频会话,但保留 MQTT 控制连接——线还在,只是这场语音听完了;猫头同样回到 Idle,下次再开音频会话。
唤醒词检测、语音对话、连接还活着,是三件不同的事,必须一起设计状态转换。只盯着其中一件,就会出现「画面还在听、人却叫不醒」的怪现场。
6. 坑清单(五条)
- 每一层都绿,整机仍可能无声。 以「用户是否听到」为准,不要只看控制台文字。「已生成」只说明模型出完了。
- 采样率与裸音频边界。 Qwen TTS 常是 24 kHz,设备协议要 16 kHz;要做连续重采样(同一轮里带着状态往下转),不能每来一块就新建一次重采样器,也不要把带文件头的 WAV/MP3 当裸 PCM 塞进扬声器——塞进去会像噪音或静音,不像「音色差」。
- 发送时钟会拖垮听感。 「发完一块再睡一块时长」会把 800 ms 音频拖到约 1.17 s;应按累计采样维护播放时钟,句间用有界队列。电杂音、卡顿也不要一口咬定是 TTS 音质差——有时是发得不均匀,喇叭在等下一帧。
- emoji 会被念出来。 大模型爱在句尾加笑脸,系统语音会读「脸颊泛红的笑脸」。过滤放在 TTS 入口,并要求模型只出适合朗读的正文。
- 堵转保护不是软件 bug。 灵敏度逻辑都还在,底座持续
STALL时,先查机械受阻并重新上电;不要用软件反复清故障掩盖问题。MQTT 联调时我也遇过:语音还能聊,底座又报故障 2——「语音接通」和「头能转」要分别验。另:唤醒后聆听时的转头一致性仓库仍标为待排查——待机听声转头 ≠ 所有场景跟随都验收。
听声转头本身:两颗麦采到的原始声音,经乐鑫 ESP-SR 里的方向估计(常称 DOA,Direction of Arrival)判断声源从哪边来。麦克风所有权要统一,不能让唤醒、识别、定位各自去抢同一路硬件采样。方向也不能直接当电机的绝对目标角——双麦正前方与底座传感器中心不在同一坐标系,要先标定再限幅。猫头自己播报时会暂停跟随,避免追着自己的喇叭转。
7. 谁该做,谁不该做
值得动手: 已有较新的 Apple Silicon;在意语音默认不进云;愿意刷固件、看日志、接受「当前可用」而不是「产品级全双工」;想搞清楚设备 ↔ 本地模型状态机的人。
建议先别硬上: 要开箱即用手机 App;要可靠的自然插话 / 回声消除;只有弱内存却想同时扛听+想+说+生图;把设计目标当成仓库已勾选能力的人。
本地换来的是可控与隐私,不是「一定比云端更聪明或更稳」。云端助手和本地 VoiceHub 可以并存——和我在《电脑的三个时代》里写的一样:隐私的事放本地,图方便的事可以继续用云。
8. 跟着做:先让 Mac 自己说话
没有喵伴也没关系。下面按仓库 README 整理,目标只有一个:先在本机把「听 → 想 → 说」摸通;设备可以后接。刷固件前请再读 firmware/README.md——这是源码发布,不是一键量产包。
默认分支当前文档以 WebSocket 设备入口为主;MQTT+UDP 见仓库技术文与 PR #1 边界。你第一次跑通,按下面做就够。
你大概需要
- 一台 Apple Silicon Mac(我测的是 M4 Max;别的芯片延迟会不一样)
- Python 3.13 左右、Homebrew
- 能访问 Hugging Face(第一次下模型;之后可离线跑已缓存的)
- 有硬件的话:ESP32-S3 猫头 + ESP32-C3 底座,和 Mac 同一局域网
第一步:把后台依赖装上
git clone https://github.com/zhiwehu/miaoban.git
cd miaoban/realtime_backend
python3 -m venv .venv
.venv/bin/python -m pip install -r requirements-local.txt
brew install ffmpeg
如果暂时只用 HTTP 模型服务,装 requirements.txt 就行。包里不含模型、VAD 权重和用户运行数据。
做到什么样算成功: 虚拟环境建好,依赖装完不报错;目录里能看到 scripts/ 和 run.sh。
第二步:把模型和 VAD 拉下来
先扫一眼各模型卡上的许可,再用虚拟环境里的 Hugging Face CLI:
.venv/bin/hf download mlx-community/Qwen3-ASR-0.6B-8bit
.venv/bin/hf download mlx-community/Qwen3-4B-Instruct-2507-4bit
.venv/bin/hf download mlx-community/Qwen3-TTS-12Hz-0.6B-CustomVoice-8bit
.venv/bin/python scripts/download_vad.py
VAD 脚本会从 Silero 固定提交拉 ONNX,校验哈希后放进本地 models/。运行适配器不会偷偷补下缺失模型——缺了就报错,这是故意的:避免「看起来在跑、其实静默下了个你没同意的东西」。
做到什么样算成功: 三个模型和 models/silero_vad.onnx 都在本地;再次启动不会因为缺文件直接退出。
第三步:写配置、预热 TTS、启动后台
.venv/bin/python scripts/configure_local.py --vad-model models/silero_vad.onnx
.venv/bin/python scripts/start_qwen_tts.py
./run.sh
configure_local.py 只在还没有配置时创建;已有配置不会覆盖,之后用网页改就行。
浏览器打开 http://127.0.0.1:8765,进「连接实验室」:先测文字(确认「想」通了),再测浏览器麦克风(需要你点授权,确认「听 → 想 → 说」通了)。第一次加载 ASR / LLM 会慢一些,属正常——模型在进内存。
TTS 服务只听本机 127.0.0.1:8767,默认 Serena、24 kHz 裸 PCM;后台会连续重采样成 16 kHz 再发给设备。日志在 data/qwen-tts.log,不记输入文本和音频。
做到什么样算成功: 网页里打一行字能出回答;再开麦克风说一句,本机听得到合成声。到这里,你已经有一条可以摸的本地链路了。下面两步可选。
第四步(可选):接上 ESP32
管理页继续只听本机;设备入口要绑 Mac 在局域网里的真实 IP(下面只是例子,务必改成你的):
./run.sh --device-host 192.168.0.10 --device-port 8766
- 设备 WebSocket:
ws://<你的Mac局域网IP>:8766/xiaozhi/v1/ - 本机取令牌:
python -m voicehub --print-device-token(别贴进 Issue、截图或仓库) - OTA 配置路径:
http://<你的Mac局域网IP>:8766/xiaozhi/ota/<DEVICE_TOKEN>/
Wi-Fi、WebSocket、OTA 按你自己固件的配置方式写入;不要拿别人机器的 NVS。刷写、分区、原厂资源见 firmware/README.md——本包没有自动擦写或一键刷机脚本。
做到什么样算成功: 喊唤醒词后,猫头能出声。控制台有字 ≠ 你听到了声——以耳朵为准。若走 MQTT 路径,请对照仓库技术文与 PR 说明单独配 Broker 与令牌,不要把 WebSocket 令牌直接复用。
第五步:确认没装歪
# 在 realtime_backend 里
.venv/bin/python -m unittest discover -s tests -v

# 仓库根目录:底座 / 方向等逻辑(不刷机)
python3 scripts/test_firmware_logic.py
当前默认分支文档侧:后端约 49 项自动化测试;另有 9 个可在主机跑的 C++ 逻辑测试。这两组都不等于麦克风、喇叭、电机已验收。MQTT 实现版本的测试数量以仓库技术文为准。
建议你按这个勾一遍
- 网页文字对话能出回答
- 浏览器麦克风能走完听 → 想 → 说(本机听得到)
- (有设备时)喊唤醒词后,猫头能出声——控制台有字 ≠ 你听到了声
- (有底座时)待机时旁人说话,头会转;若底座报
STALL,先查机械受阻并重新上电,别急着清软件故障
9. 仓库与下一步
- 仓库:https://github.com/zhiwehu/miaoban
优先读README、docs/ARTICLE.zh-CN.md、docs/VALIDATION.md、docs/PROTOCOL.md、firmware/README.md。 - 我后面还关心:真实外放回声消除与自然插话、唤醒后跟随矩阵、长稳与多设备、更干净的 workflow 文档;MQTT 合入默认分支后的安装说明也会跟着收紧。
如果你复现了某条坑,或测到和文中差很多的延迟,欢迎开 issue,写清芯片、内存、接入方式(WebSocket 还是 MQTT+UDP)、是否并行生图 / 别的 LLM——比空泛的「很快 / 很慢」有用得多。
参考
-
喵伴 · VoiceHub 源码
https://github.com/zhiwehu/miaoban -
仓库内技术文与验证边界
https://github.com/zhiwehu/miaoban/blob/main/docs/ARTICLE.zh-CN.md
https://github.com/zhiwehu/miaoban/blob/main/docs/VALIDATION.md -
MQTT 实现与测试记录(PR #1,合入状态以仓库为准)
https://github.com/zhiwehu/miaoban/pull/1 -
Qwen3-ASR / Instruct / TTS(Hugging Face 官方卡)
https://huggingface.co/Qwen/Qwen3-ASR-0.6B
https://huggingface.co/Qwen/Qwen3-4B-Instruct-2507
https://huggingface.co/Qwen/Qwen3-TTS-12Hz-0.6B-CustomVoice -
MLX Audio / MLX LM
https://github.com/Blaizzy/mlx-audio
https://github.com/ml-explore/mlx-lm -
Espressif ESP-SR(声源方向)
https://github.com/espressif/esp-sr -
AITi NO.011《电脑的三个时代:PC、AI PC 和 AC》
https://www.getaiti.com/articles/011-three-eras/
订阅 · SUBSCRIBE
扫码关注公众号
文章每周更新,网站和公众号「AITi智能」同步发布。想在微信里第一时间看到,扫码关注。
- 01 微信搜索「AITi智能」
- 02 关注并加星标
- 03 每周更新,不见不散
扫码关注 · 每周一篇