归档 / NO.006 · 本地 AI · 开源模型 · 实测
Qwen3.8-27B 实测:128GB 的 MacBook,才刚喂饱它
不聊参数,聊体验。一个开源 27B 模型在 MacBook 里住了一个多月:喂过 20 万 token、干了两天真活之后的一些真实感受。
本文章节 · CONTENTS 10
8 月 14 日晚上,阿里把 Qwen3.8-27B 挂上了 Hugging Face。三天后,我的时间线上全是同一张截图:发布时的榜单上,它拿了 52 分,和 GPT-5.6 Luna 持平,离当时最强的几个模型只差 1 分。
而它是一个 27B 的开源模型,协议随便商用,一台大内存的电脑就能装下。
我发布第四天就开始折腾了,之后一个多月,它一直住在我这台 128GB 的 MacBook Pro M4 Max 上。这篇文章不讲参数,就说说一个开源「准旗舰」长期放在个人电脑里,到底是什么感觉。
先用大白话说说它是个什么模型
现在流行的模型大多是 MoE 架构:参数总量很大,但每生成一个字只激活其中一小部分,相当于「省电模式」。Qwen3.8-27B 不是,它是 dense(稠密)模型——每生成一个字,整个模型都要在内存里完整过一遍。所以它费内存、也吃带宽,这是后面所有体验的根源。
它还能看图、看长视频,不只是文字模型。训练时还自带了一个「加速外挂」(MTP:一次猜好几个字,猜对了一起收下),后来社区的各种提速方案,全是建立在这个设计上。
它的长上下文(原生 26 万 token)也是靠取巧:64 层里只有 16 层需要保存完整的注意力记忆,其余 48 层用一种几乎不占内存的替代结构。所以开满长上下文,缓存也只占 16GB——27B 敢标 262K,底气在这。
最后两条实用信息:协议是 Apache 2.0,商用没问题;官方只放了「原味」大权重,大家平时跑的压缩版全是社区做的——所以同样叫 Qwen3.8-27B,换一个版本、换一个软件,体验可能差很远。
分数是真的,但别太迷信
「编程能力超越 Qwen3.7-Plus」这个说法我核对过官方表格,基本属实:编程和 Agent 这类任务上(比如真实终端任务测试 Terminal-Bench 73.0 对 64.0),这个装进电脑的 27B,确实压过了阿里自家上一代云端付费版。
但要分清楚:它赢的是编程和 Agent,不是什么都赢。通用知识类测试它还是输给上一代云端版。而且那些分数是官方自己跑的,用了自家工具链和自建评测,听听就好。
还有个小插曲:我写文章时再去查那个 52 分,发现榜单方法这一个月里已经更新,今天的排名已经不是发布那天那个 52 了。榜单这东西,描述的是「发布那一周」,不是永恒真理。
Reddit 上这一个多月,大家都在聊什么
这个模型在 r/LocalLLaMA 刷屏了一个多月。最热闹的是一个「你跑出了多少速度」的帖子,385 条评论,变成了一份民间速度对照表:RTX 3090 跑 30–45 tok/s,Mac 这边从 M4 Pro 24GB 的 11 到 M1 Max 的 16 不等。我这台 M4 Max 的 45 tok/s,在 Mac 里算快的,但社区有人用更硬核的玩法在同款机器上跑到 70 多——省事路线不是极限路线。
好评集中在编程和 Agent:有人说它是「第一个真正愿意长期留在本地干活的模型」;有位用户修好工具调用的配置之后,Agent 任务成功率从 67% 跳到了 92.5%。
最大的槽点是「太爱想」。有人实测:一个编程请求,它先闷头思考了 142 秒才开始回答;同一个问题关掉思考模式,28 秒给出能用的代码。但关了思考,大家又普遍反映它明显变笨——两头堵。
我的体验和社区几乎一样,这两个点后面都会讲到。
我这台机器上的真实数字
运行时我用的是最省事的 Ollama。它不是最快的路,但我平时就这么用,这篇文章的数字也不想换一个平时不会开的环境来跑。以下是 9 月 17 日上午重跑的结果:
| 场景 | Prefill | 解码速度 | 备注 |
|---|---|---|---|
| 短上下文(约 20 token) | — | 44.5 – 45.4 tok/s | 三次重复取值稳定 |
| 约 1K 上下文 | 249.7 tok/s | 42.0 tok/s | |
| 约 7.4K 上下文 | 218.2 tok/s | 41.2 tok/s | |
| 约 14.8K 上下文 | 212.4 tok/s | 39.0 tok/s | |
| 约 27.8K 上下文 | 180.4 tok/s | 35.7 tok/s | 冷前缀 |
| 27.8K 之后追问 | 前缀缓存命中 | 34.0 tok/s | 首 token 约 3.2s |
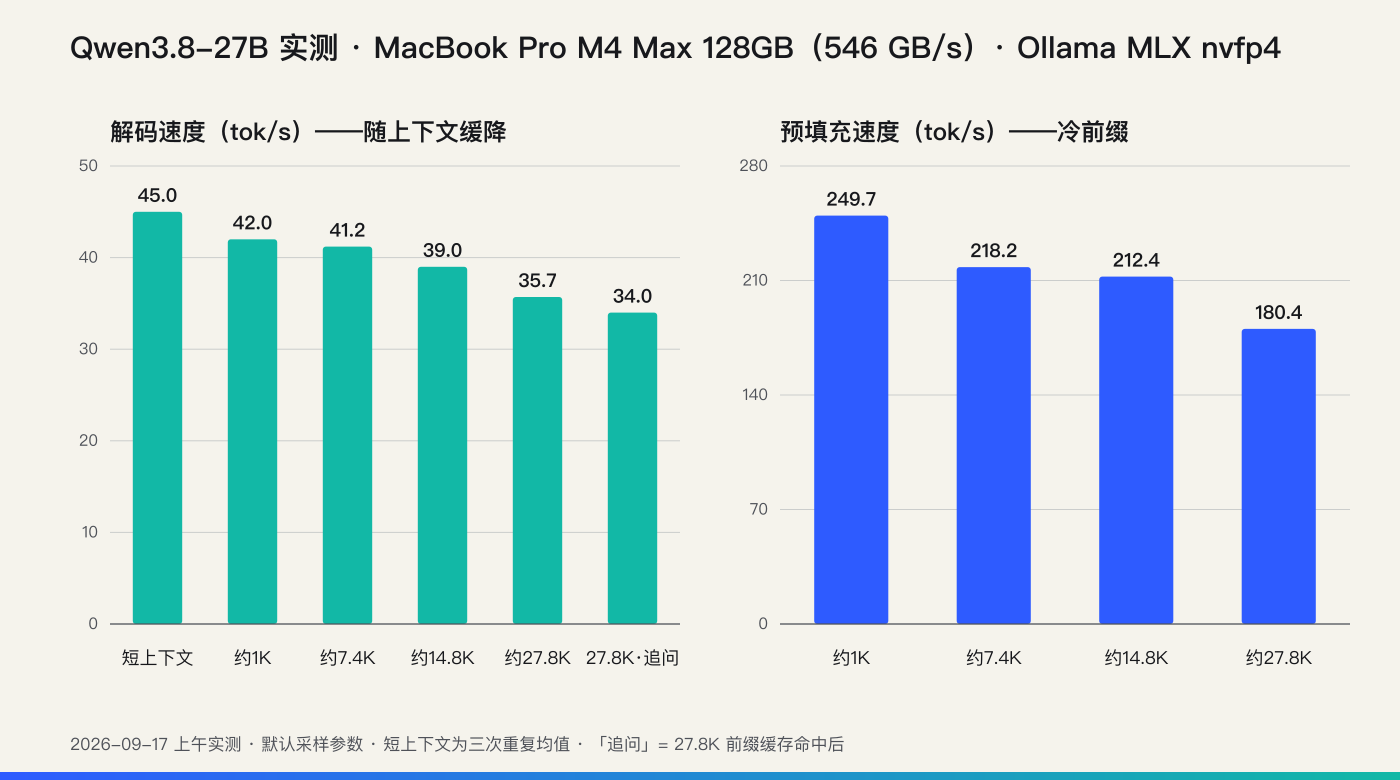
三个比数字本身更有意思的发现。
第一,45 tok/s 是「加速外挂」加持后的成绩。 按内存带宽算,纯解码上限也就三十多;日志里能看到 MTP 在持续工作,猜中率七八成。这也是社区有人关掉它只测到 24.6 的原因——我每天看到的 45,已经包含了这部分收益。
第二,笔记本上的真瓶颈不是吐字,是「吃文档」。 喂上下文的速度实测 180–250 tok/s,一份 6 万 token 的文档冷着喂进去要四分多钟。好在有前缀缓存:资料喂过一次,继续追问只算增量,秒级开口。长上下文体验好不好,一半看你会不会顺着这个脾气用。
第三,内存比「18GB」那个标签大得多。 软件启动就按最大上下文拿缓存空间,日常常驻 30GB 出头;上下文一大还会继续涨(后面说到 52GB)。128GB 无感,48GB 就得掂量了。
还有一个没弄明白的小问题:哪怕只有一句话的小请求,首字也要 2.5–3.3 秒,像是每次请求的固定开销,疑似和视觉模块有关,没深究。影响很明确——它当不了语音助手的大脑,但拿来干活,这个延迟无所谓。
我把 20 万 token 塞了进去
官方标称支持 26 万 token 上下文,我一直想试试往极限推。
翻 9 月 9 日晚上的日志,找到了那次实验:一个 20.5 万 token 的文档,分了八段才喂完,前缀缓存一节节往上爬,内存从 40GB 一路涨到 52.36GB。
结论有两层。塞得进去:一整本书的量,机器没崩,同时浏览器、IDE 照常开着——128GB 的意义就在这。但塞进去不等于用得好:它在这么长的内容里找东西,可靠性还达不到「托付」的程度。以后再看到「原生 262K」,我会自动拆成两个问题:能不能装,和装满之后还好不好用。
速度也是账:20 万 token 冷处理要 17 分钟,没有前缀缓存的话,这个长度在个人电脑上没法当普通交互用。
让它干了两天真活
比起跑分,我更愿意看一个模型能不能把真实项目做完。
9 月 8 日到 9 日,我让它做了一个完整项目:PyTurtle Studio——一个在浏览器里直接跑真 Python 的编程 IDE。代码是真正的 CPython 在浏览器里执行,海龟画图画在网页画布上,还带一个能输入输出的控制台。
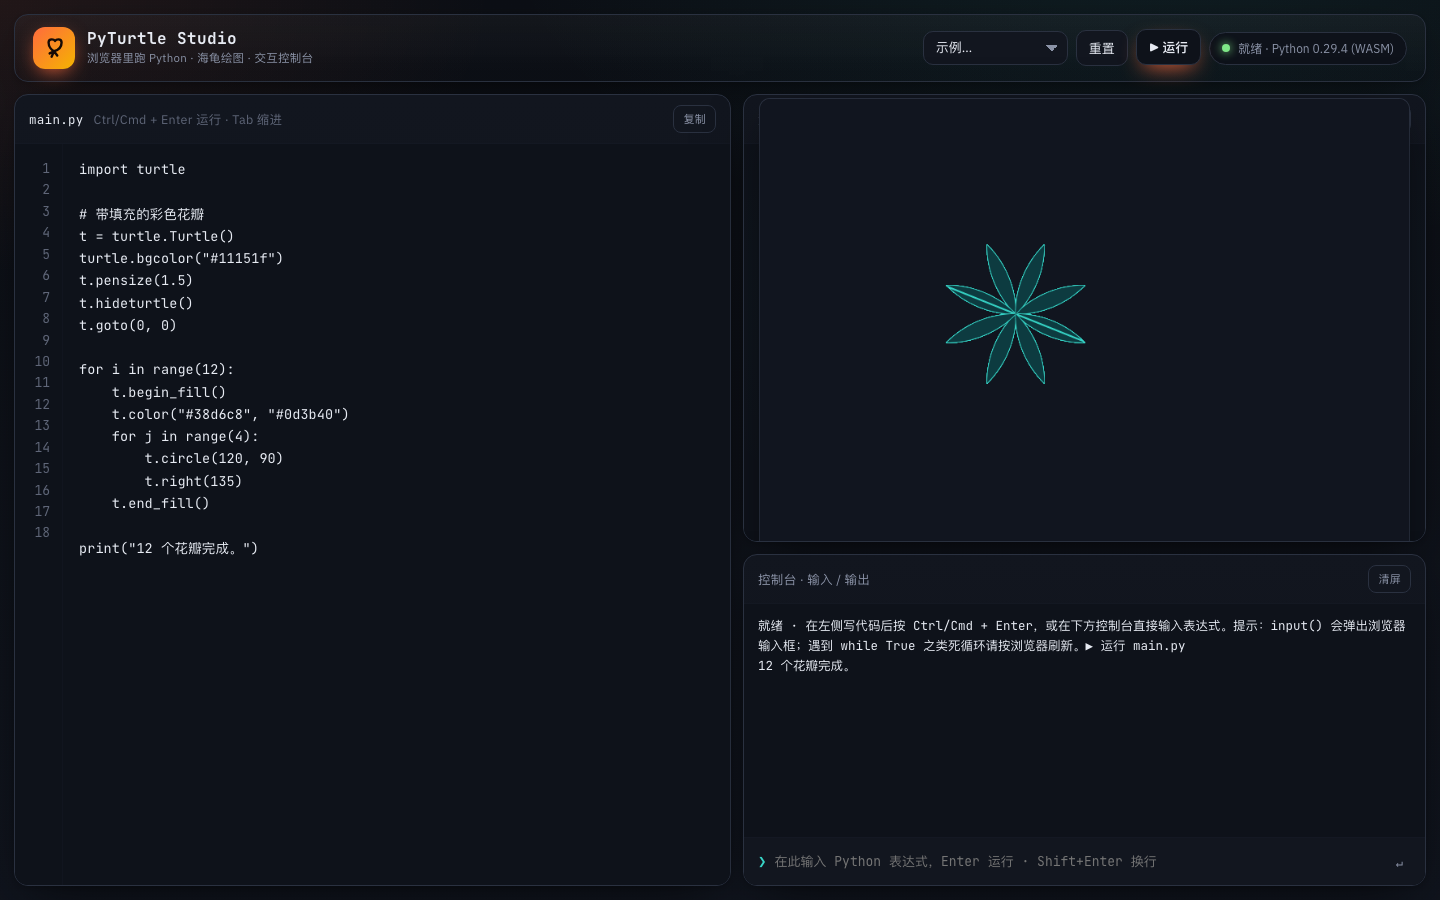
两天的日志统计:154 次请求,纯模型计算累计约 5 小时,最长一次 12 分钟。我的工作方式是把需求说清楚,让它自己做,过一会儿回来检查,不对再让它改。
最后交付 8 个文件、2300 行代码,开箱能用。
比行数更意外的是,它自己给项目配了一整套验证:画图模块有单元测试,有一个模拟全流程的自测脚本,还有在真实浏览器里逐像素检查画面的脚本,连「打包回单文件」都写了个小工具。Reddit 说它会主动写测试,这次我亲身验证了。
慢也是真的——那 12 分钟就是深度思考的时间。坐在屏幕前等它会很难受,但当「接个需求让它自己磨」的工人用,节奏反而舒服。连项目文档里的「已知缺陷」都是它自己老实写下来的。这一点,比跑分高几分更有说服力。
128GB 到底买到了什么
如果只问「能不能跑起来」,32GB 内存就有机会,没那么夸张。
但「跑起来」和「住进来」是两回事。模型占 30GB,实验时涨到 52GB,同时我的浏览器、IDE、终端照常开着,还能再挂一个小模型。电脑还是我的电脑,没有因为跑它变成一台什么都不敢动的专用机器。
至于速度——128GB 买不到速度(那由内存带宽决定),买到的是余量:不用做任何取舍的余量。到了这个档位,这个模型才算真正「住」进了电脑里。
27B dense 还值得跑吗
论坛上吵得最凶的就是这个:同样内存,为什么不跑更快的 MoE?
我一个月用下来的答案不是二选一,是分工:要快开口的事(语音、问答、补全)交给小模型和 MoE;要质量的重活(代码审查、长文档分析、Agent 干活)交给它。 一个月下来,重任务我已经习惯性先扔给它了。
还有一笔很现实的账:放在自己机器里的模型,调用一百次也不多一分钱。它不一定比云端聪明,但它让我敢放开手用——这一点,实际用过才知道有多重要。
写在最后
这篇文章写到最后,我印象最深的不是 128GB,也不是 45 tok/s。
而是这个变化本身:本地模型的进步,已经不只是「模型越做越大」——训练、后训练、压缩、推理软件、加速技巧,全都在同时往前走。
云端模型变强,我们感觉不到背后的区别;但本地不一样。我的电脑不会明年自动多一倍内存,可同样这台电脑,明年可能就跑一个明显更聪明的模型。硬件已经买回来了,接下来值得期待的,是还能往里装进多少新能力。
参考资料
- Qwen3.8 官方仓库与模型卡:https://github.com/QwenLM/Qwen3.8 ;https://huggingface.co/Qwen/Qwen3.8-27B
- Artificial Analysis:Qwen3.8-27B:https://artificialanalysis.ai/models/qwen3-8-27b
- Simon Willison:Qwen3.8-27B scores 52(2026-08-17):https://simonwillison.net/2026/Aug/17/qwen-38-27b-scores-52/
- 凤凰网科技:阿里开源 Qwen3.8-27B(2026-08-15):https://tech.ifeng.com/c/8vbMNx17cfF
- 量子位:Qwen3.8-27B 开源:https://www.qbitai.com/2026/08/473379.html
- smeltcore:Qwen3.8-27B on Apple M4 Max:https://smeltcore.com/recipes/qwen3-8-27b-on-apple-m4-max-4-bit-mlx-vision-language-at-the-full-262k-context/
- Apple MacBook Pro 技术规格:https://support.apple.com/en-us/121553
- Ollama qwen3.8:https://ollama.com/library/qwen3.8
- mlx-community:https://huggingface.co/mlx-community/Qwen3.8-27B-4bit ;ggml-org:https://huggingface.co/ggml-org/Qwen3.8-27B-GGUF
- DFlash2:https://huggingface.co/incoai/Qwen3.8-27B-DFlash2 ;https://inco.ai/blog/dflash2/
- MTPLX 社区改版:https://huggingface.co/Youssofal/Qwen3.8-27B-MTPLX-Optimized-Speed
- Reddit 实测帖:tok/s 晒机帖 https://www.reddit.com/r/LocalLLaMA/comments/1vqjeub/ ;量化评测 https://www.reddit.com/r/LocalLLaMA/comments/1vz3ieu/ ;M4 Pro 24GB 实测 https://www.reddit.com/r/ollama/comments/1vrqi3d/ ;M1 Max 对比 https://www.reddit.com/r/ollama/comments/1wa0feg/ ;Gemma4 vs Qwen 讨论 https://www.reddit.com/r/LocalLLaMA/comments/1vyzopv/
- oMLX + ANE + MTP 的 M4 Max 128GB 实测:https://github.com/Weschera/Qwen3.8-27B-oMLX-MTP-Mac
- Hacker News 发布讨论:https://news.ycombinator.com/item?id=49299605
- 本文实测原始日志与脚本:Ollama server log(2026-09-06 ~ 09-17)、自建基准脚本
写作声明:本文观点和实测由作者完成;AI 参与资料检索、数据整理和文字校对。官方 benchmark 均按官方口径引用;社区数据来自公开讨论,部分结果为发帖者自述,本文未逐项复现。
如果这篇文章对你有用,欢迎关注公众号「AITi智能」——每周更新。网站版同步发布:getaiti.com
订阅 · SUBSCRIBE
扫码关注公众号
文章每周更新,网站和公众号「AITi智能」同步发布。 想在微信里第一时间看到,扫码关注。
- 01 微信搜索「AITi智能」
- 02 关注并加星标
- 03 每周更新,不见不散
扫码关注 · 每周一篇