归档 / NO.007 · 本地 AI · Agent · 图片生成 · 实测
不调用云端 API,我用 Qwen-Image 2.1 搭了一个本地绘本智能体
把语言模型、Agent 和图片生成全部搬进本地:一本 8 页的猫绘本和一本 7 页的日系短篇漫画,是怎么被一个 Agent 自己画出来的。
本文章节 · CONTENTS 13
本文速览
- 我搭了一条完全本地的绘本生产线:DeepSeek Harness + 本地 LLM → dsh-image-gen → ComfyUI → Qwen-Image 2.1,不调用任何云端生图 API,也不按张付费。
- 跑通了两本成品:8 页的动物绘本《Miso and the Moon Market》,和 7 页的日系短篇漫画《BLOOM》。
- 角色一致性不靠提示词硬记,靠视觉锚点:先生成一张角色设定图,之后每一页都把它当参考图一起送进去。
- 速度是这套方案目前最大的短板:1536×864、15 步,一张大约 126 秒。它适合扔给 Agent 在后台慢慢跑,不适合坐在屏幕前等。
- 权重是 Qwen Research License,商业用途要另外核对授权。
这两年 AI 生图已经不是什么新鲜事了。
如果只是想生成一张好看的图片,现在用云端模型很方便。人物、场景、文字、参考图编辑,包括以前比较麻烦的角色一致性,都已经进步了很多。所以这次我想试的,其实不是「AI 能不能做一本绘本」。
我更感兴趣的是另外一件事:
能不能把这套东西搬到本地,而且不只是把图片模型装在电脑里,而是真的让一个本地 Agent 自己写故事、设计角色、逐页生成图片,最后整理成一本完整的绘本?
不调用云端生图 API,也不按生成次数付费。
前几天我把这件事情基本跑通了。
其中一本叫《Miso and the Moon Market》。
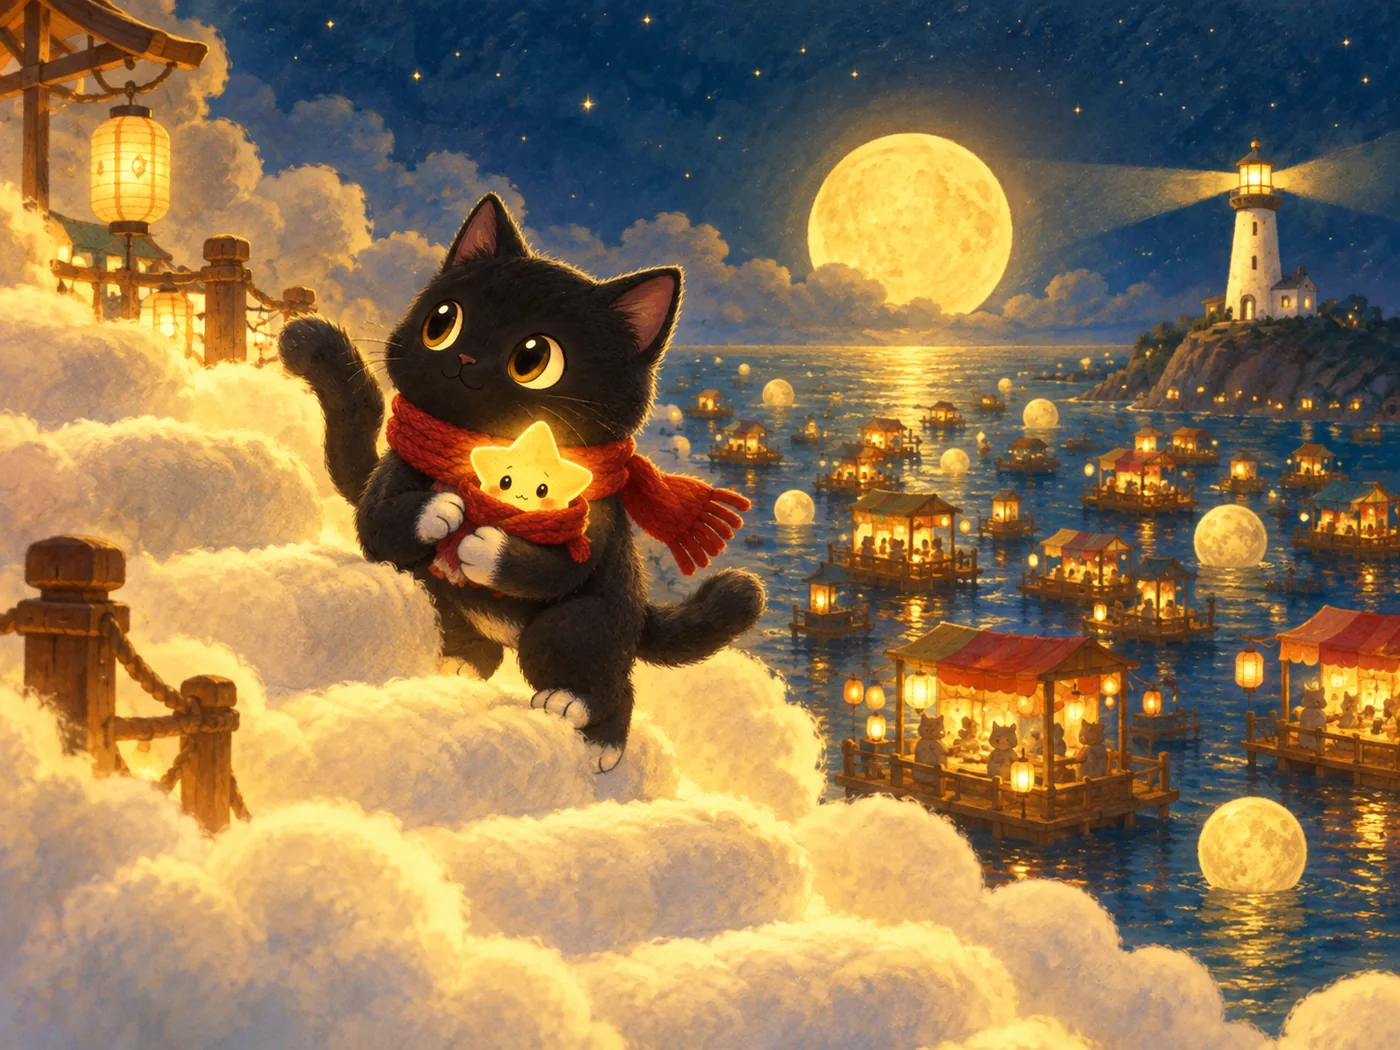
主角是一只戴红围巾的小黑猫。故事从海边的灯塔开始,Miso 顺着云做成的阶梯来到月亮集市,最后帮助了一颗从天空掉下来的小星星。整个 PDF 是封面 + 8 页正文,人物、配色和画风基本保持住了。
上面那张就是其中一页:Miso 抱着小星星站在云做的阶梯上,远处是月亮集市和灯塔。
我后来又试了一次完全不同的风格,做了一个 7 页的日系短篇漫画《BLOOM》。这一次不再是动物绘本,而是固定的人类角色、多格分镜、对白框,以及比较连续的情绪变化。
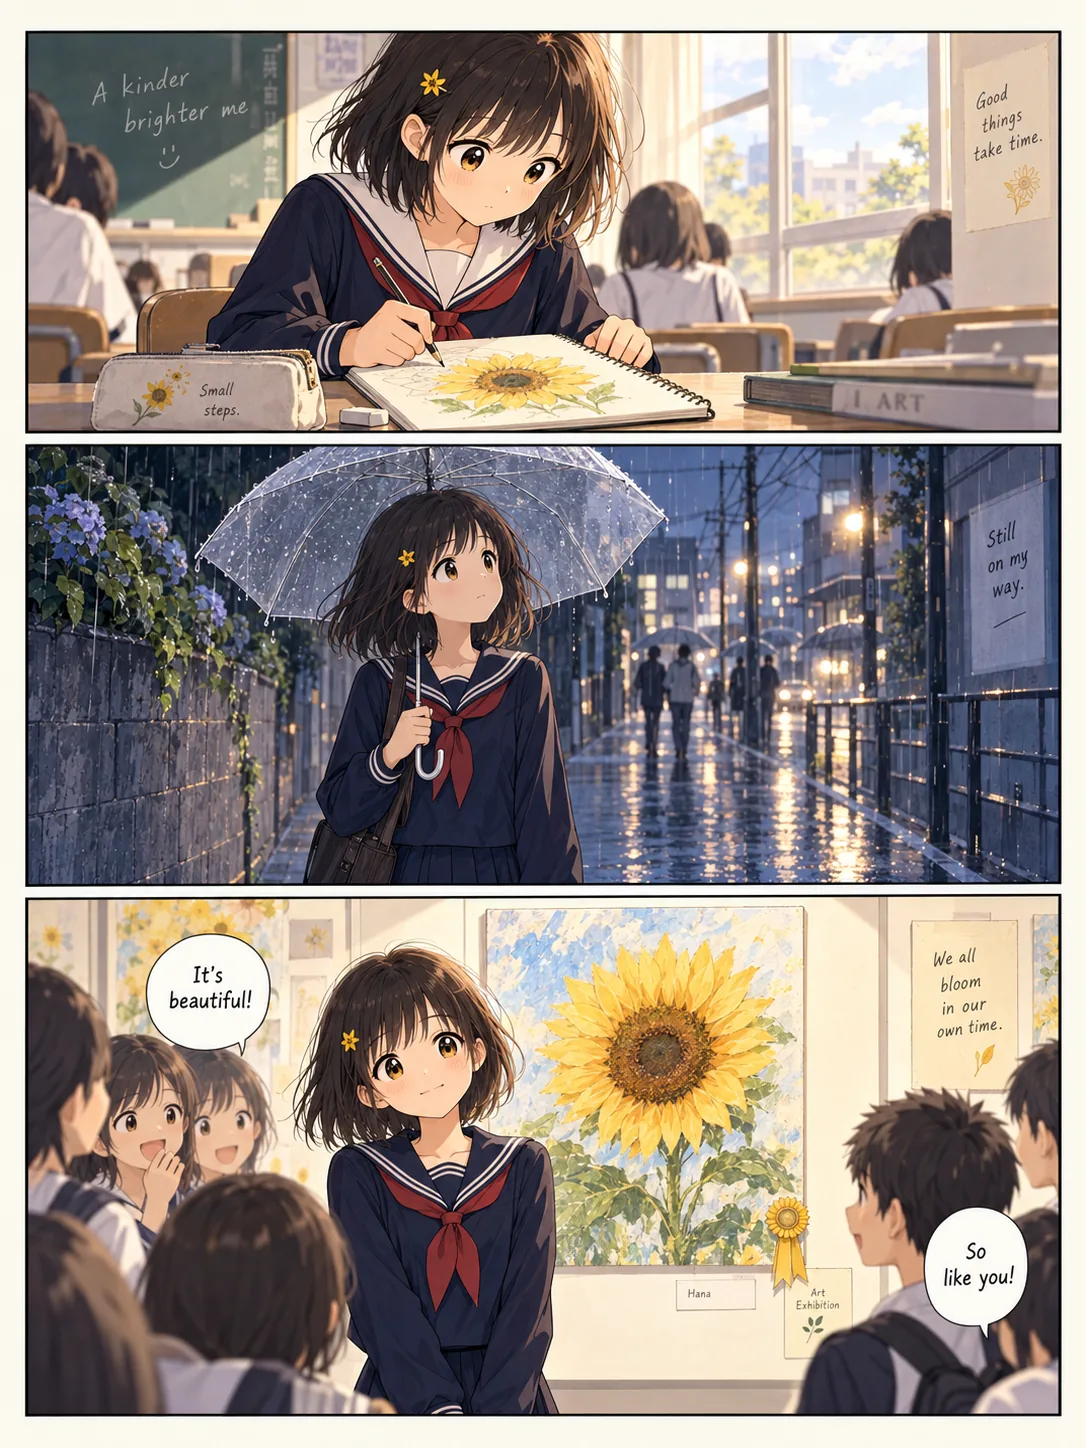
图:《BLOOM》内页。同一页里的三个分镜,也是这套流程里最难的部分:固定人物、连续情绪、外加对白文字
它们当然都还谈不上出版级作品。有些文字需要校对,角色在复杂镜头下也不是百分之百一致。但对我来说,这次实验有意思的地方已经不在于「这张图画得像不像」。
而是从我输入一个需求开始,后面的很多事情已经可以交给 Agent 自己去做了。
我以前也折腾过本地生图
2024 年买现在这台电脑以后,我就装过 Stable Diffusion。
那时候文生图已经可以做得很好,但真的开始折腾以后,很容易掉进各种技术细节里面。想固定人物,要研究参考图、Seed、ControlNet;想要某种画风,要找 Checkpoint、LoRA;生成的姿势不对、手不对、表情不对,又要继续换参数。
这些技术本身都没有问题,甚至很好玩。但我一直不太喜欢一种状态:为了画一张图,人需要先变成半个「生图工程师」。
我真正想要的接口一直都是自然语言。
我说清楚自己要什么,后面的事情尽量由模型完成。
2025 年二三月份,我开过一个在线 AI 学习班,其中有一部分就是教大家用 n8n,把 LLM 和云端图片模型串起来做绘本。
那一次其实已经解决了不少问题。
LLM 可以先写故事,然后自动拆成若干页,再给每一页生成 Prompt,n8n 负责按顺序调用图片 API。过去需要手工复制粘贴几十次的事情,第一次变成了一条可以自己跑下去的工作流。
但它仍然是一条提前设计好的流水线,而且图片最终还是在云端生成。生成一次算一次钱,角色不满意再来一张,构图有问题再来一张,一本十几页的东西如果每页试几个版本,图片数量很快就上去了。
这一次我想把事情再往前推进一点:语言模型、Agent、图片生成,尽可能全部留在本地。
从 Stable Diffusion 到 n8n 再到今天,我真正在变的其实不是模型,而是自己站的位置:以前是我操作软件一张一张做图,现在是我给 Agent 一个任务,中间隔一会儿看看它做到哪里。
我现在用的是这样一套东西
这次的结构其实不复杂。
用户
  ↓
DeepSeek Harness + 本地 LLM
  ↓
dsh-image-gen
  ↓
ComfyUI
  ↓
Qwen-Image 2.1
  ↓
图片
  ↓
排版脚本
  ↓
PDF
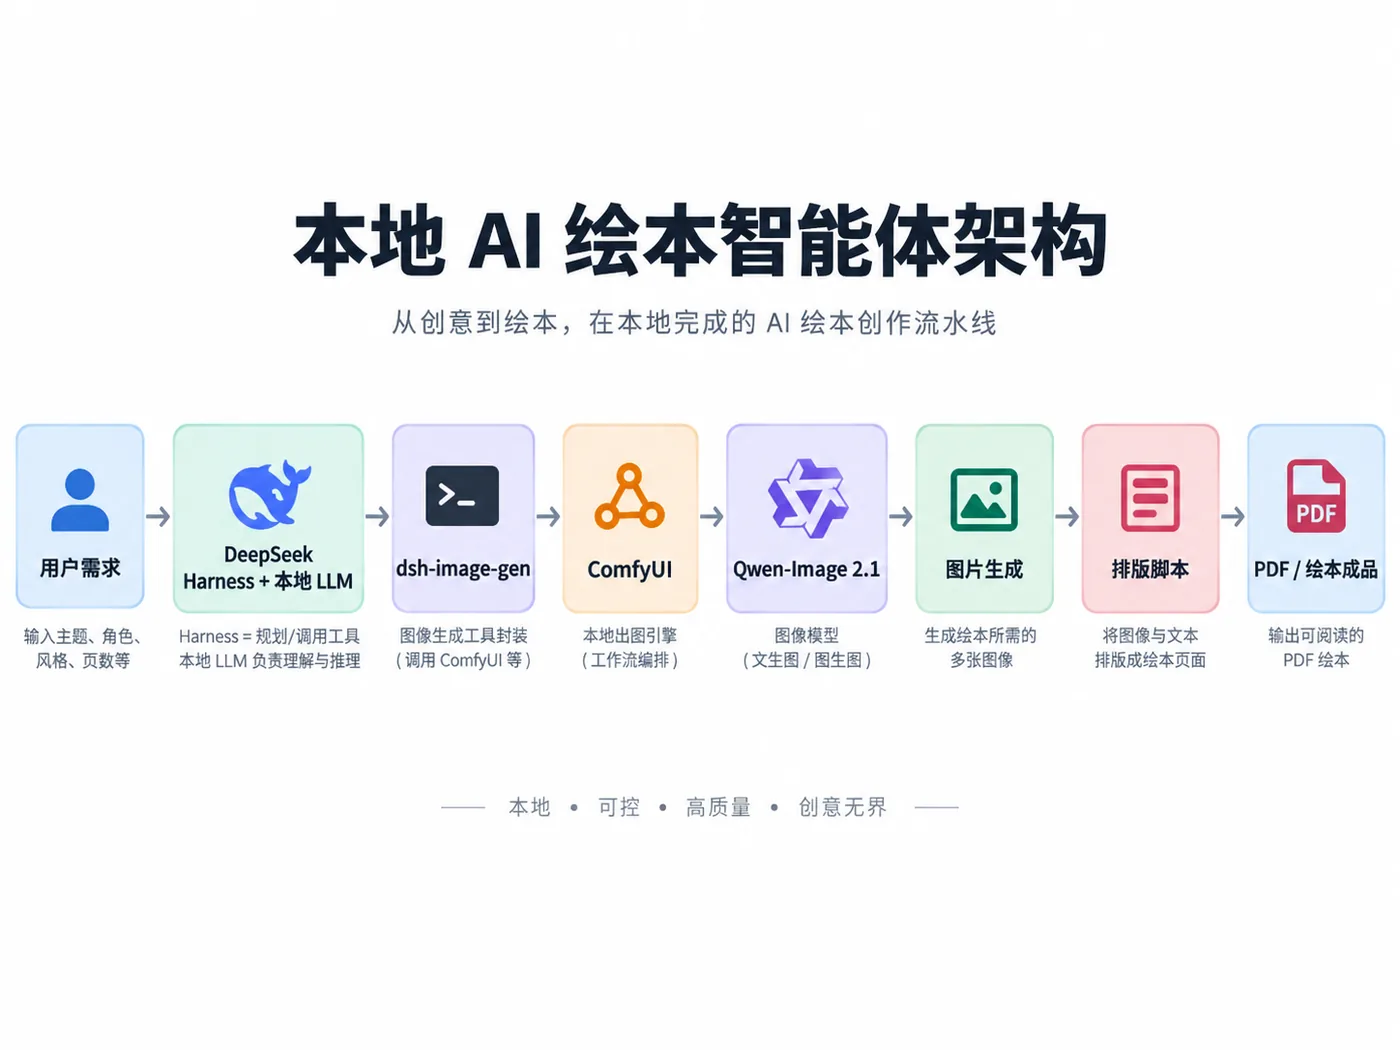
图:DeepSeek Harness、dsh-image-gen、ComfyUI 与 Qwen-Image 2.1 的整体关系
最上面是 DeepSeek Harness。我这次给它接的是本地运行的 Qwen3.8-27B(就是第 006 期写过的那个 27B dense 模型,完整实测在这里)。它负责理解我的要求、写故事、拆页面以及决定什么时候去调用图片工具。
中间的 dsh-image-gen 是一个很关键的小插件,也是我自己写的:它把 generate_image、edit_image 这样的能力注册成 Agent 可以直接使用的工具,再往下调用本地 ComfyUI。没有它,Agent 就只能「说」要画什么,没法真的把图落到硬盘上。
最下面才是 Qwen-Image 2.1,真正负责把图画出来。
所以我这次其实很少直接操作 ComfyUI。
ComfyUI 还在那里,节点工作流也还在那里,只是它逐渐从「我每天面对的软件」退到了后台,变成了一个提供 API 的本地图像引擎。DeepSeek Harness 负责和我打交道,ComfyUI 负责干活。
我觉得这种分层很重要。
很多时候我们说「Agent 会使用工具」,听起来有点抽象。放到这个例子里就很具体了:Agent 并不需要学会点击 ComfyUI 的几十个节点,它只需要知道自己什么时候应该调用 generate_image,什么时候应该带一张参考图调用 edit_image。
底下的复杂度被包装起来了。
这也是我现在越来越喜欢 Harness 这种做法的原因。
Qwen-Image 2.1 本地要跑哪些东西
Qwen-Image 2.1 并不是下载一个文件就结束。
我这次实际使用的 BF16 版本主要有三部分:
| 组件 | 大小 | 用途 |
|---|---|---|
| 7B DiT | 14.23GB | 图片生成主体 |
| Qwen3-VL 8B | 17.53GB | 文本编码、参考图理解 |
| VAE | 0.68GB | 图像编解码 |
| 合计 | 32.44GB |
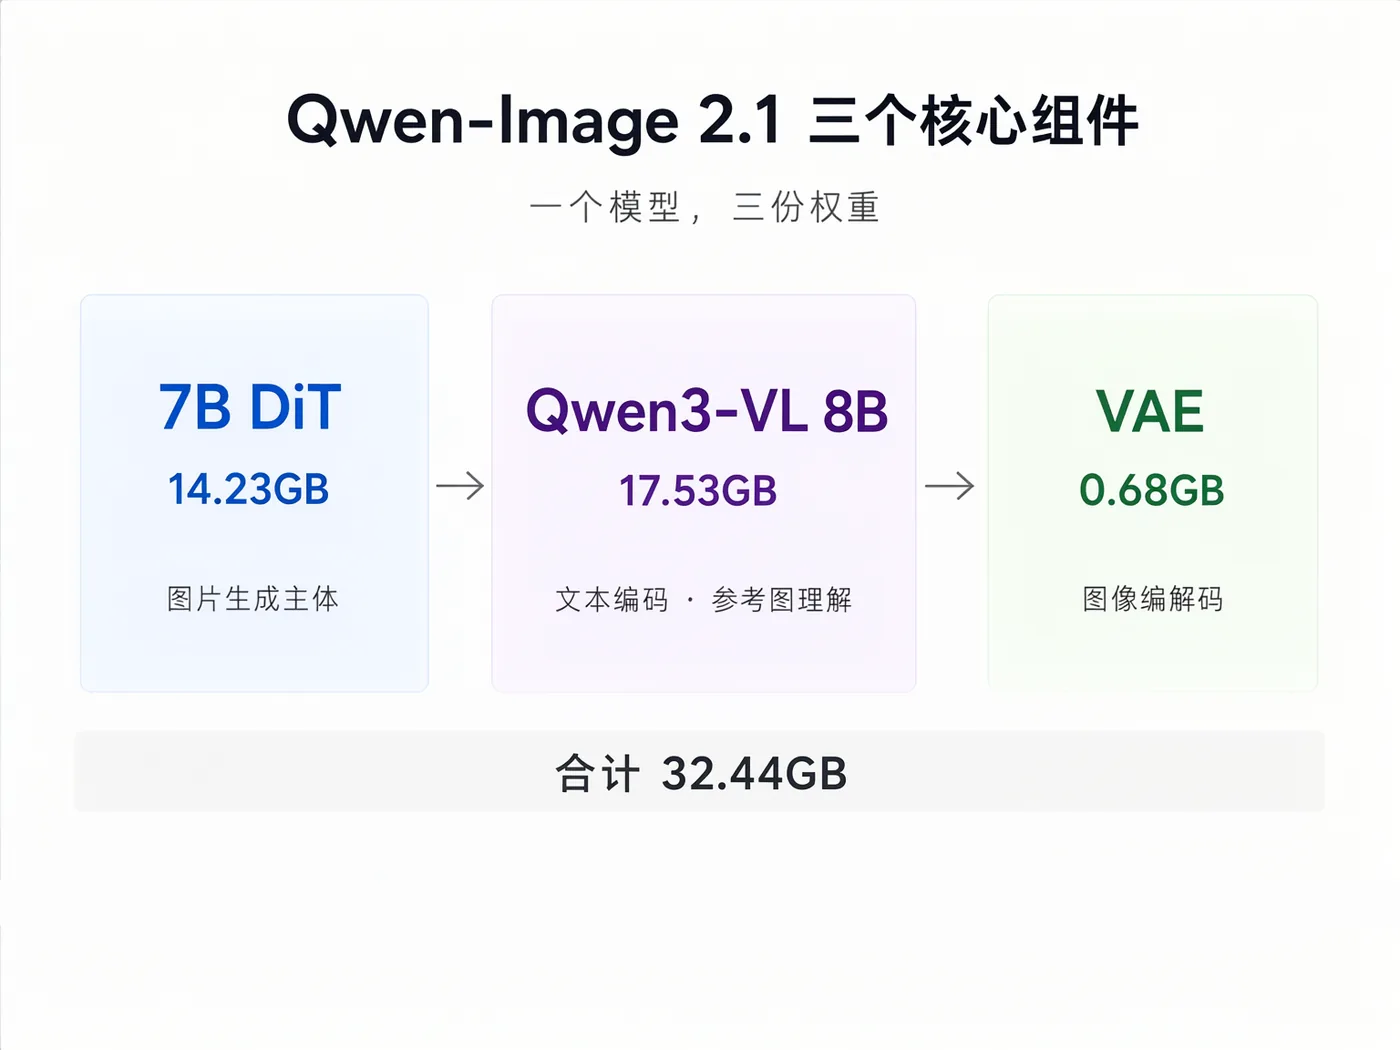
图:三份权重合计 32.44GB,分别放进 ComfyUI 的 diffusion_models / text_encoders / vae 三个目录
模型本身是单流 DiT + Flow Matching 架构,原生支持较高分辨率输出,也支持参考图片编辑。这里我特别关注的是中间那个 Qwen3-VL 8B,因为后面做绘本时,角色一致性很大程度上就依赖它对参考图片的处理。
我的实测环境是 MacBook Pro M4 Max 128GB,不过这篇文章并不是想讨论 Mac。
它只是我手边正好有的一台机器。
Mac 上需要注意的一点是,这次我直接用了 BF16,而不是仓库里的 int8_convrot 或 w4a8。后两者针对的是 CUDA 内核,MPS 并不能从中得到对应的加速。在我后面的实测里,int8 版本反而比 BF16 慢了 8%~15%。
如果是 NVIDIA 显卡,这个结论就不能照抄了:那边 int8 / fp8 量化是能真正吃到硬件加速的,显存占用也会明显下来,通常是优先选项。不同硬件最终应该选什么版本,要看具体运行时。
安装 ComfyUI 本身现在很简单。我直接用了 ComfyUI Desktop,模型分别放到:
diffusion_models/
text_encoders/
vae/
真正让我折腾了一会儿的反而是版本和模型目录。
我安装时 Homebrew 里的 Desktop 构建版本还比较早,需要先让 App 自己更新,后端升级到包含 TextEncodeQwenImage21 节点的版本。另外新版 Desktop 的共享模型目录已经是:
~/ComfyUI-Shared/models/
不是网上很多旧教程里的 ~/Documents/ComfyUI。
本地服务跑在 127.0.0.1:8188。
这种问题没什么技术含量,但往往最浪费时间。模型明明三十几个 GB 都下载好了,结果 ComfyUI 就是不认识,最后发现只是目录错了。
下载 32GB 模型,比安装还麻烦
这次部署里花时间最多的一个坑,其实是下载。
我测试了几个源。
Hugging Face 直连基本不可用,代理情况下我测到大约 220KB/s;hf-mirror 从几十 KB 到 1MB/s 不等;最后换到 ModelScope,单连接大约能到 17MB/s,两路并行时到 33MB/s 左右。
最后三个 BF16 文件大概 20 分钟下载完。
而且 ModelScope 上已经有 Comfy-Org/Qwen-Image-2.1 对应的 ComfyUI 格式,不需要自己做权重转换。
这类细节我本来不太想写,但考虑到这篇文章可能真有人照着装,还是留下来。现在国内部署开源模型,很多时候最困难的步骤不是推理,而是先把几十 GB 文件完整地弄到硬盘里。
我后来还对 safetensors 的文件头、dtype、data offset 和官方大小做了校验。三个文件都是 BF16,文件长度也和仓库一致。对于几十 GB 的权重,这一步我觉得值得做,不然最后运行失败,很难判断到底是环境问题还是下载到一半文件坏了。
ComfyUI 里真正需要的节点并不多
把官方工作流拆开看,核心其实没有想象中复杂。
CLIPLoader
    ↓
TextEncodeQwenImage21
    ↓
KSampler
    ↓
VAEDecode
    ↓
SaveImage
另外把 UNETLoader 接到 KSampler,把 EmptyLatentImage 作为初始 latent。
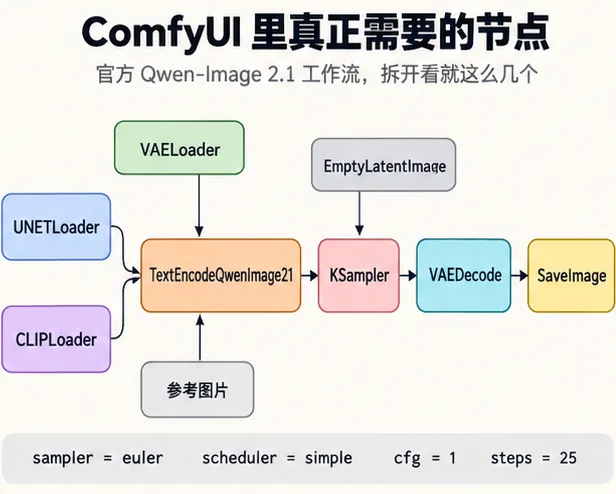
图:官方的 Qwen-Image 2.1 工作流拆开看,核心就这么几个节点
官方几个默认参数我开始基本没有动:
sampler   = euler
scheduler = simple
cfg       = 1
steps     = 25
这里有一个和以前玩 Stable Diffusion 习惯不太一样的地方:CFG 就用 1。
Qwen-Image 2.1 的 guidance 已经在文本编码阶段处理。如果继续在 KSampler 这里把 CFG 往上拉,实际上又做了一层引导。我的测试里,CFG 拉到 2.5、开始使用 negative prompt 以后,时间会明显变长。
这件事刚开始还有点不习惯。
以前调生图模型,经常会想「提示词不够听话,是不是 CFG 还不够大」。这一次反倒是 Prompt 本身写清楚更重要。
一本绘本里,最麻烦的其实还是角色
如果每一页都完全从文字重新生成,即使今天的模型已经很好,角色仍然会漂。
所以《Miso and the Moon Market》不是让 Agent 每次都重新描述:
「a black cat wearing a red scarf」。
我先单独生成了一张 Miso 的角色设定图。
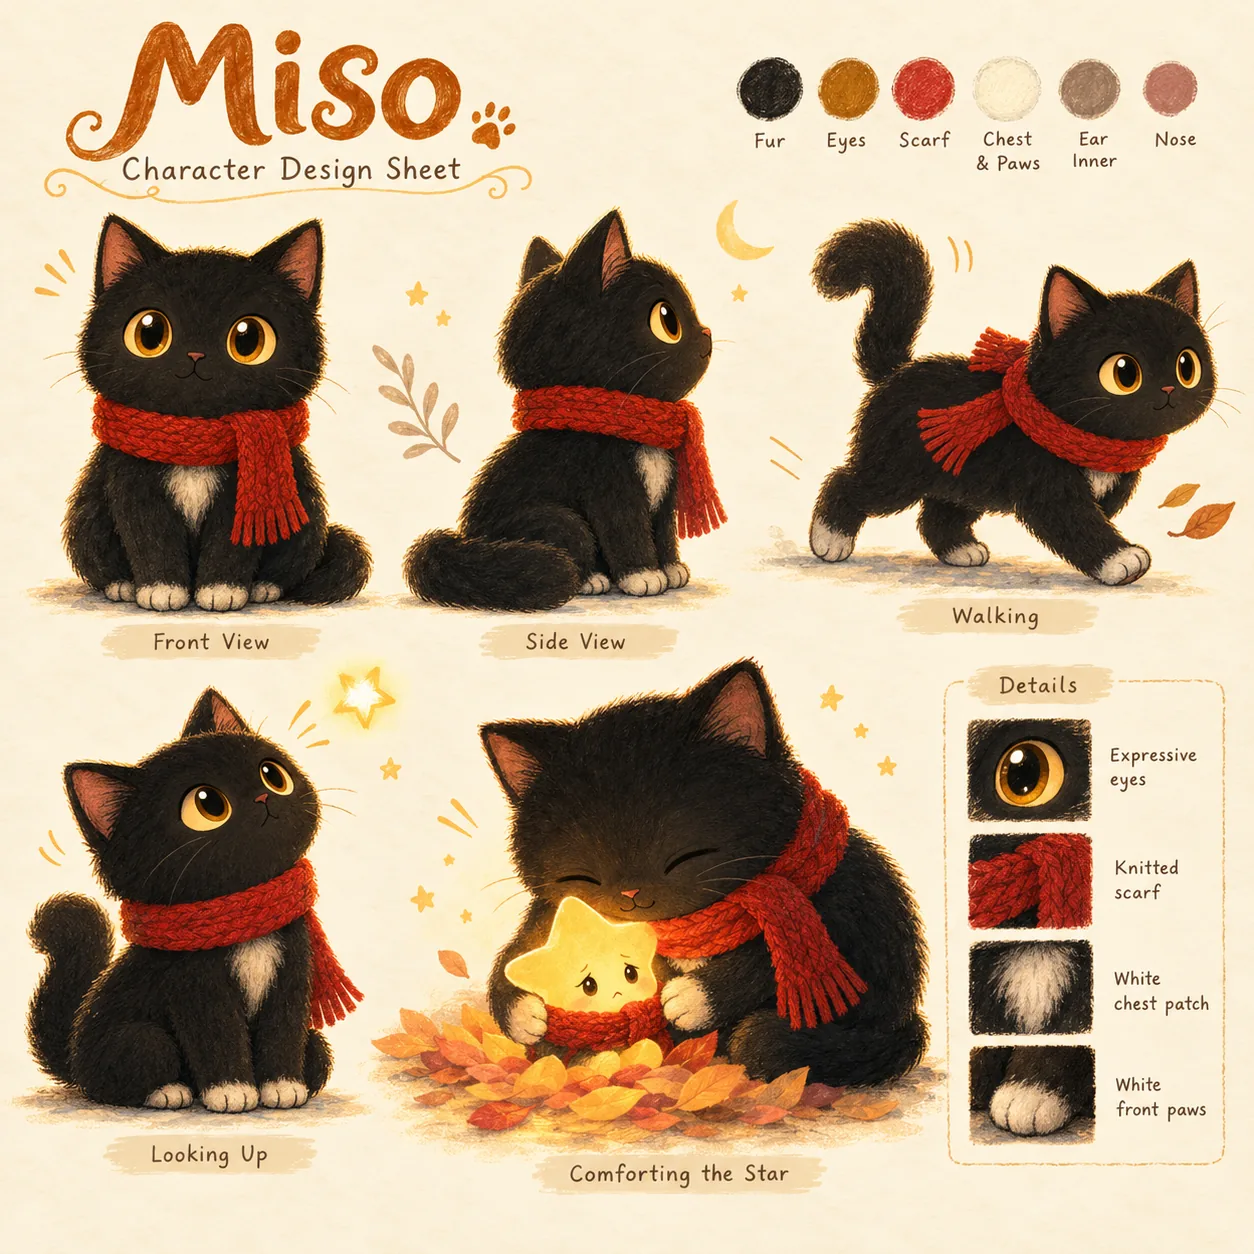
图:根据 Miso 成品角色整理的角色设定图示意,用来说明视觉锚点的概念
黑色身体、琥珀色眼睛、胸口白斑、红色围巾,这些特征先固定下来。后面每一页生成时,再把这张图片作为 Reference Image 一起送进去。
因此新的 Prompt 主要描述变化的部分,例如:
「站在云梯上回头。」
「来到月亮市场的摊位前。」
「怀里抱着一颗发光的小星星。」
而不是每一次重新从零定义 Miso。
在 ComfyUI 里面,参考图片接入 TextEncodeQwenImage21,同时还需要把 VAE 接进去,让参考图片先被编码,再进入 conditioning。
这也是我觉得现在做连续内容比较重要的一个思路:
不要指望模型凭 Prompt「记住」角色。
给它一个稳定的视觉锚点。
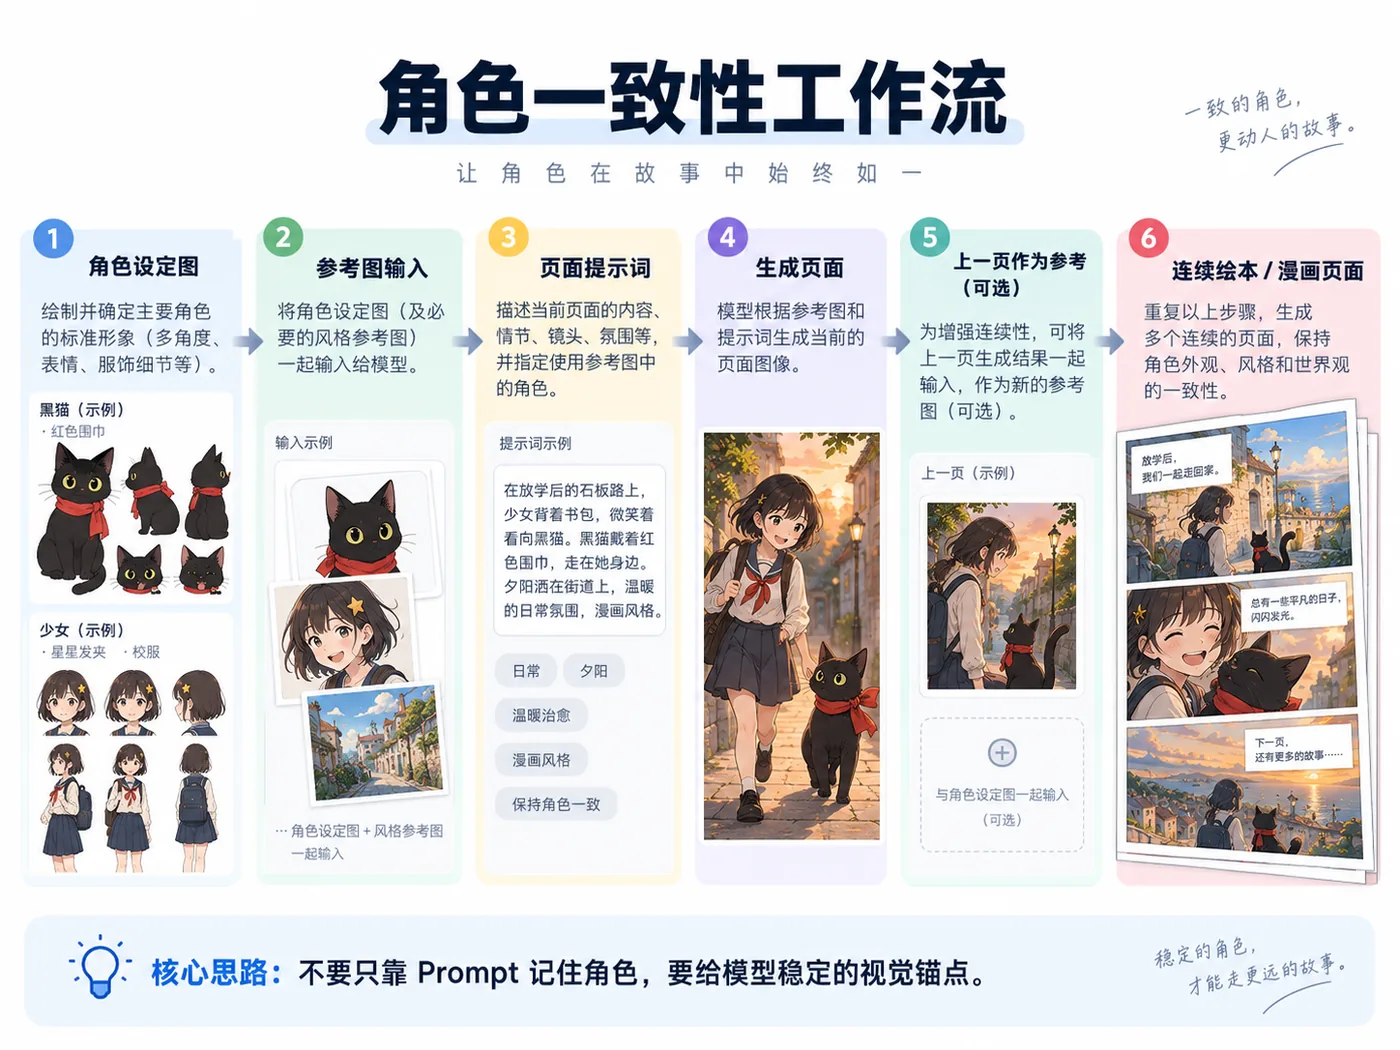
图:角色设定图 → 参考图 → 页面提示词 → 连续页面
如果两页剧情是连续的,还可以在角色设定图之外,再把上一页也作为参考。角色图告诉模型「这个角色是谁」,上一页则告诉它「上一秒发生了什么」。
Qwen-Image 2.1 本身支持多参考图,这给后面做连续漫画留下了不小的空间。
《BLOOM》就是我后来继续做的另一种尝试。从猫换成人以后,对角色一致性的要求明显更高:发型、眼睛、发饰、制服,只要其中一个东西变化,人眼很快就能看出来。
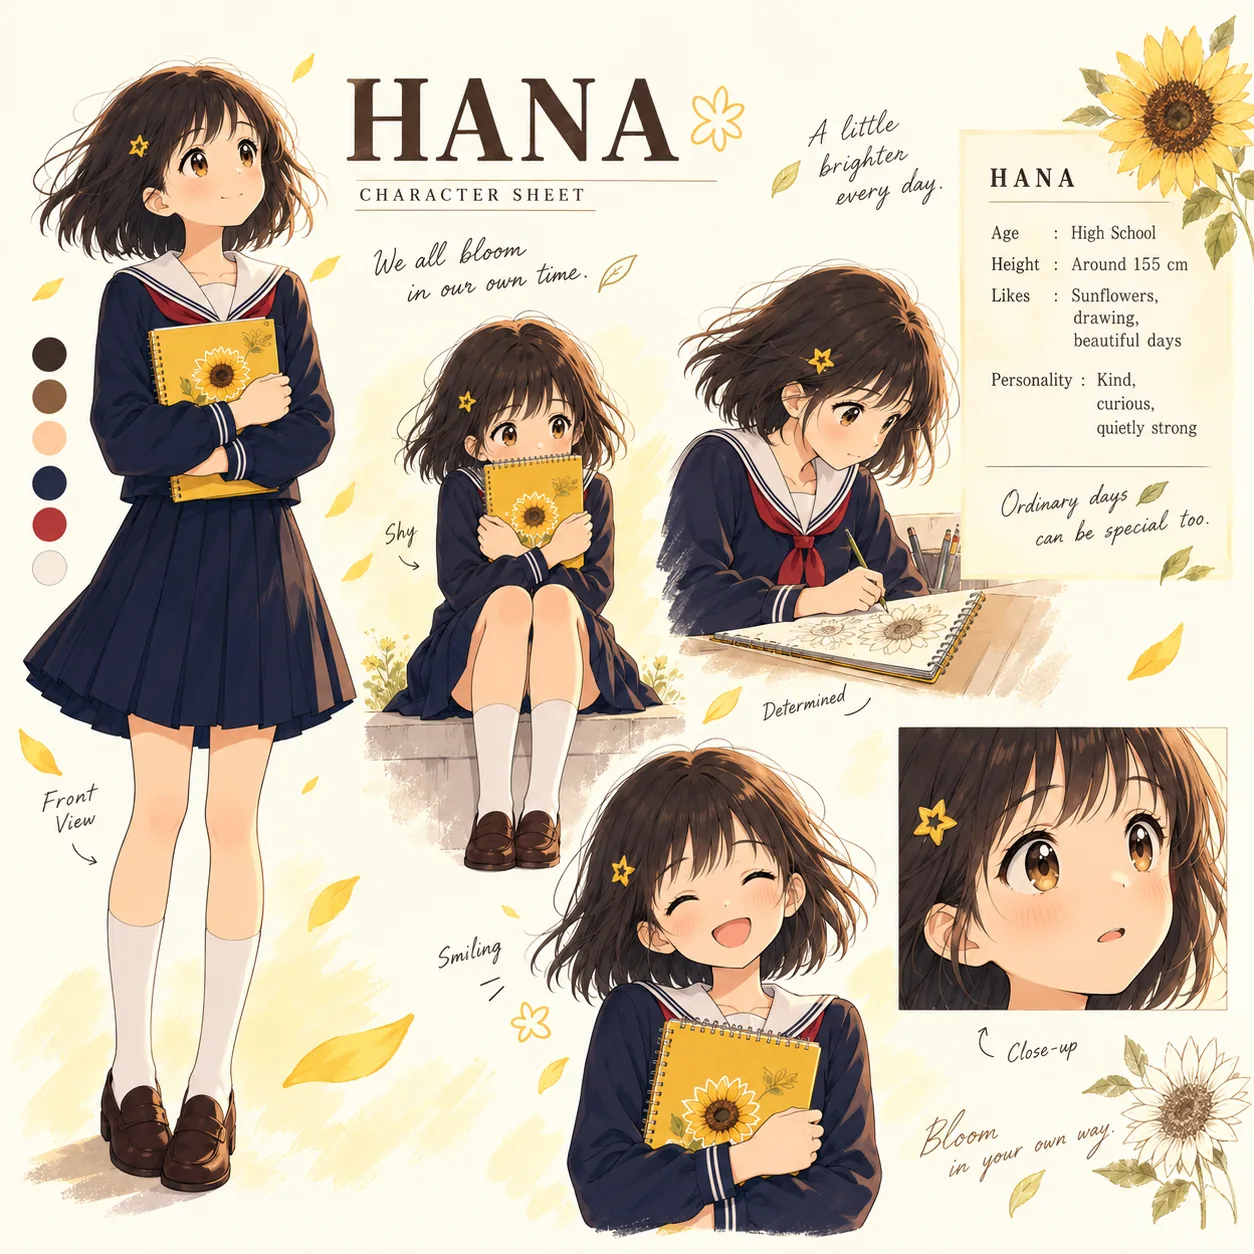
图:根据《BLOOM》主角形象整理的人类角色设定图示意
最后出来的结果不完美,但至少让我确认,这套方法并不只适合做动物绘本。
接下来才轮到 Agent
如果只是做到上面这一步,其实还是一个普通的 ComfyUI 工作流。
真正让我觉得这件事开始变得有意思,是把它接进 DeepSeek Harness 以后。
dsh-image-gen 的工作流本质上还是普通的 JSON。我只需要预留几个注入点:
"prompt": "{{prompt}}",
"seed": "{{seed}}",
"image": "{{image}}"
Agent 不需要知道 KSampler 的节点编号,也不用理解 VAE 的线怎么连。
它只需要知道这一页应该画什么,然后把 Prompt 交给工具。如果要保持角色,就同时带上参考图片。插件负责把这些内容填进工作流,再发给 ComfyUI 的 /prompt API。
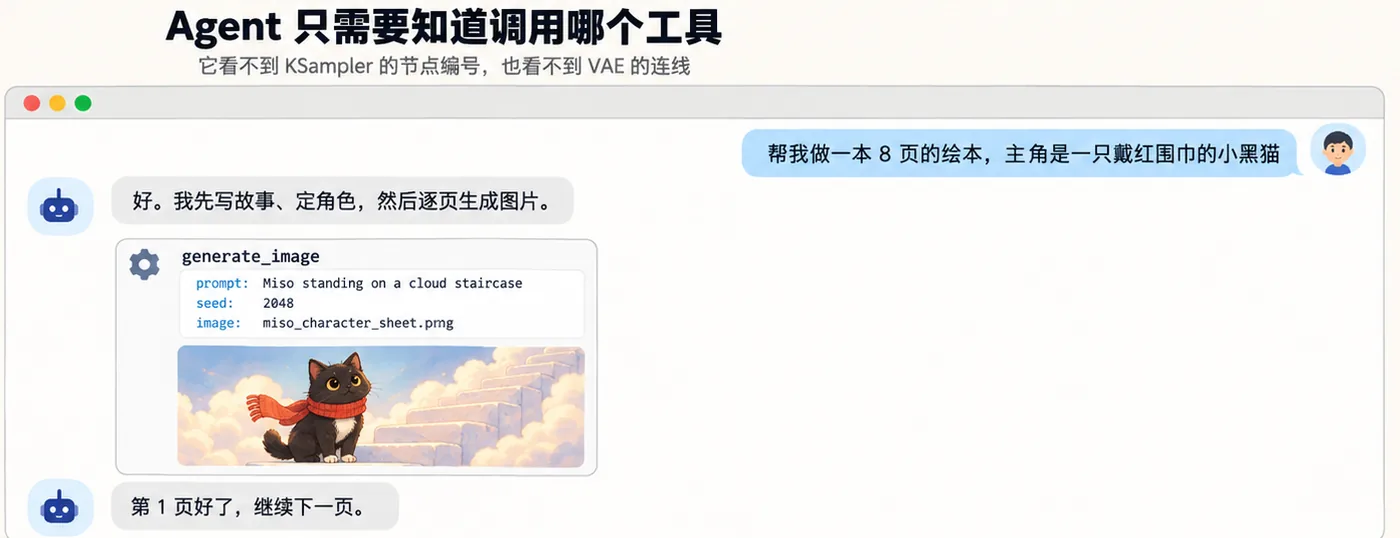
图:Agent 看到的只是「调用哪个工具、给什么参数」,看不到底下那张节点图
于是整本书的过程变成了:
先写故事。
确定页数。
设计角色。
生成角色设定图。
把故事拆成每一页。
为每一页组织图片 Prompt。
带着角色参考逐页生成。
生成完所有图片以后,再用一小段 Python,把文字和图片排到一起,输出 PDF。
我这版最后的排版代码只有二十行左右,用的是 PIL。
当然,目前这还不是一个按一下按钮就完全不用管的产品。
生成过程中我还是会看结果。有的页面构图不好,有的角色姿势不满意,就让它重新来。文字尤其需要检查,Qwen-Image 2.1 虽然已经可以把文字直接画进气泡,但数字、生僻字仍然可能出错,正式出版肯定不能跳过人工校对。
但工作方式已经不太一样了。
以前是我操作生图软件,一张一张做。
现在更像是我给 Agent 一个任务,中间隔一会儿看看它做到哪里,有问题再告诉它改。
这点和我最近使用本地模型写代码的感觉其实很像。
本地生成到底有多慢
这是我最开始比较担心的问题。
如果一张图要二三十分钟,那么「本地免费」其实意义有限,因为人等不起。
我最后主要用 1536×864 做测试。模型热加载后,25 步、CFG=1,一张大概 235~293 秒。
后来把 Steps 降到了 15。
一张大约 126 秒。
和 25 步相比快了接近一半,而我实际看生成结果,画质损失并不明显。所以目前我做日常测试,15 步反而是比较常用的设置。10 步虽然还能降到大约 118 秒,但收益已经很小,因为前面模型准备的固定开销占了不少。
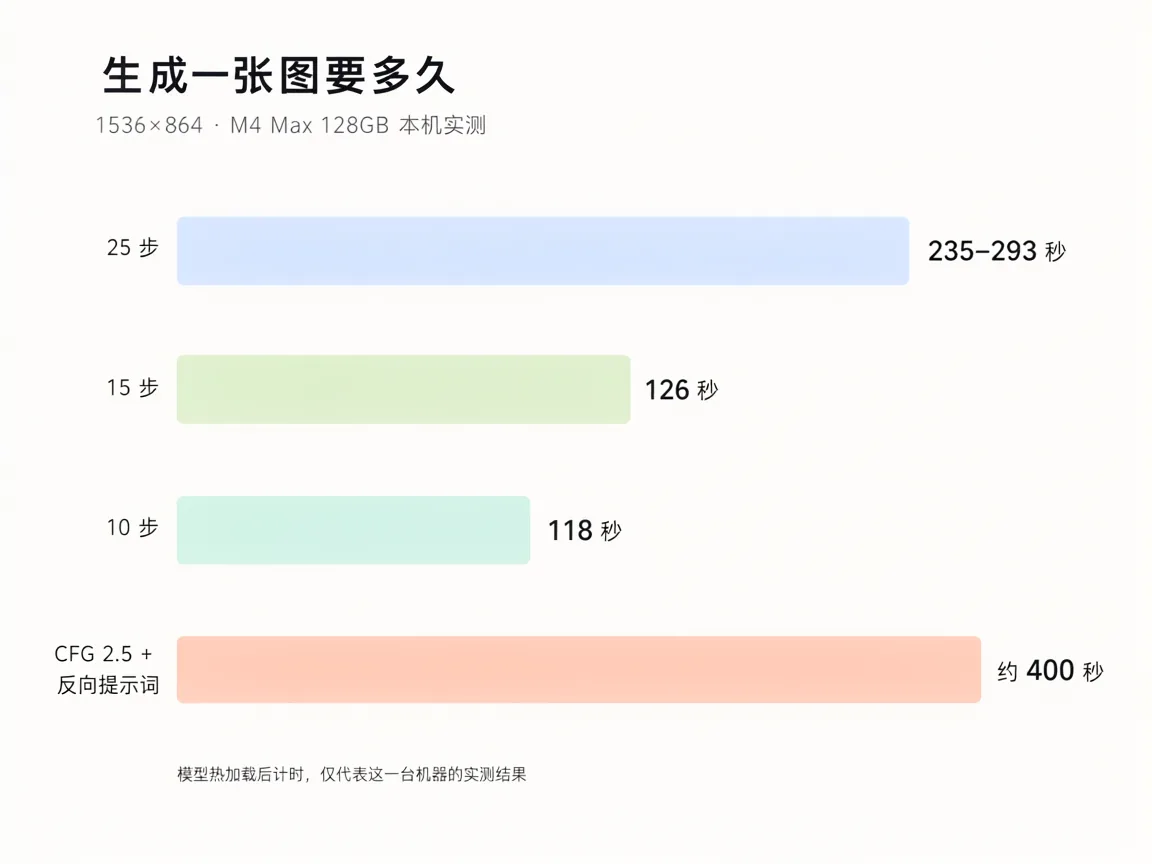
图:1536×864、模型热加载、M4 Max 128GB 的本机实测。只代表这一台机器
参考图模式还会再慢一些。
因为角色图片需要走一遍 Qwen3-VL 的视觉编码,实际一张可能多花一两分钟。我的环境里给 ComfyUI 加 --gpu-only,让编码器从 CPU 移到 MPS 后,这部分会好一些。
所以这套方案并不快。
至少今天,它还没有快到让我坐在那里看着图片一张接一张实时出现。
但换一个使用方式以后,我觉得这个速度已经可以接受。
让 Agent 在后台慢慢跑。我去干别的事情,一会儿回来检查。
这和追求聊天模型「几十 token/s」的体验其实不是一回事。
为什么我还是愿意把它放在本地
如果只是偶尔生成三五张图片,我不会建议每个人都花时间搭这一套。
打开云端服务,输入 Prompt,可能是更合理的选择。
本地的意义在批量使用以后才慢慢出来。
绘本就是一个很典型的例子。一页可能生成得不错,也可能需要试三次;十页就是三十张。如果再生成角色设定、封面、备用构图,很容易跑到五十张。
更重要的是 Agent 不会像人一样舍不得点「重新生成」。
给它足够的权限以后,它可以失败、修改,再试。对于 Agent 来说,大量试错本来就是一种正常的工作方式。
但如果每次试错背后都对应一次云端 API 费用,你会天然希望它「少试几次」。
本地模型的情况不同。
模型下载完成以后,再多生成一张图片增加的是算力时间和电费,而不是又多一笔 API 调用费用。
这两个成本模型最后会影响 Agent 的设计方式:一个是「前期投入高、之后边际成本接近于零」的曲线,一个是「用多少付多少」的直线。前者才养得起一个愿意反复试错的 Agent。
另外一个原因是数据。
普通的绘本可能无所谓,但以后这套东西不一定只拿来做 Miso。
公司还没发布的角色、产品设计稿、客户素材、孩子照片,甚至内部 Storyboard,都可能成为参考图片。如果这些内容从语言模型到图片生成全部可以留在本地,就少了一层关于数据应该传到哪里的顾虑。
我觉得这可能才是本地图像模型比较长期的价值。
不是为了证明「我的电脑也能画图」。
而是因为当图片生成成为 Agent 的一种工具以后,我们会希望这个工具像本地 Python、文件系统、数据库一样,可以一直在那里,需要的时候随时调用。
现在还有不少问题
跑完这两个例子以后,我没有觉得「AI 漫画已经解决了」。
反而问题看得更清楚了一些。
首先还是一致性。
角色设定图解决了大部分问题,但面对复杂动作、多人物、镜头大幅变化以后,漂移仍然会发生。
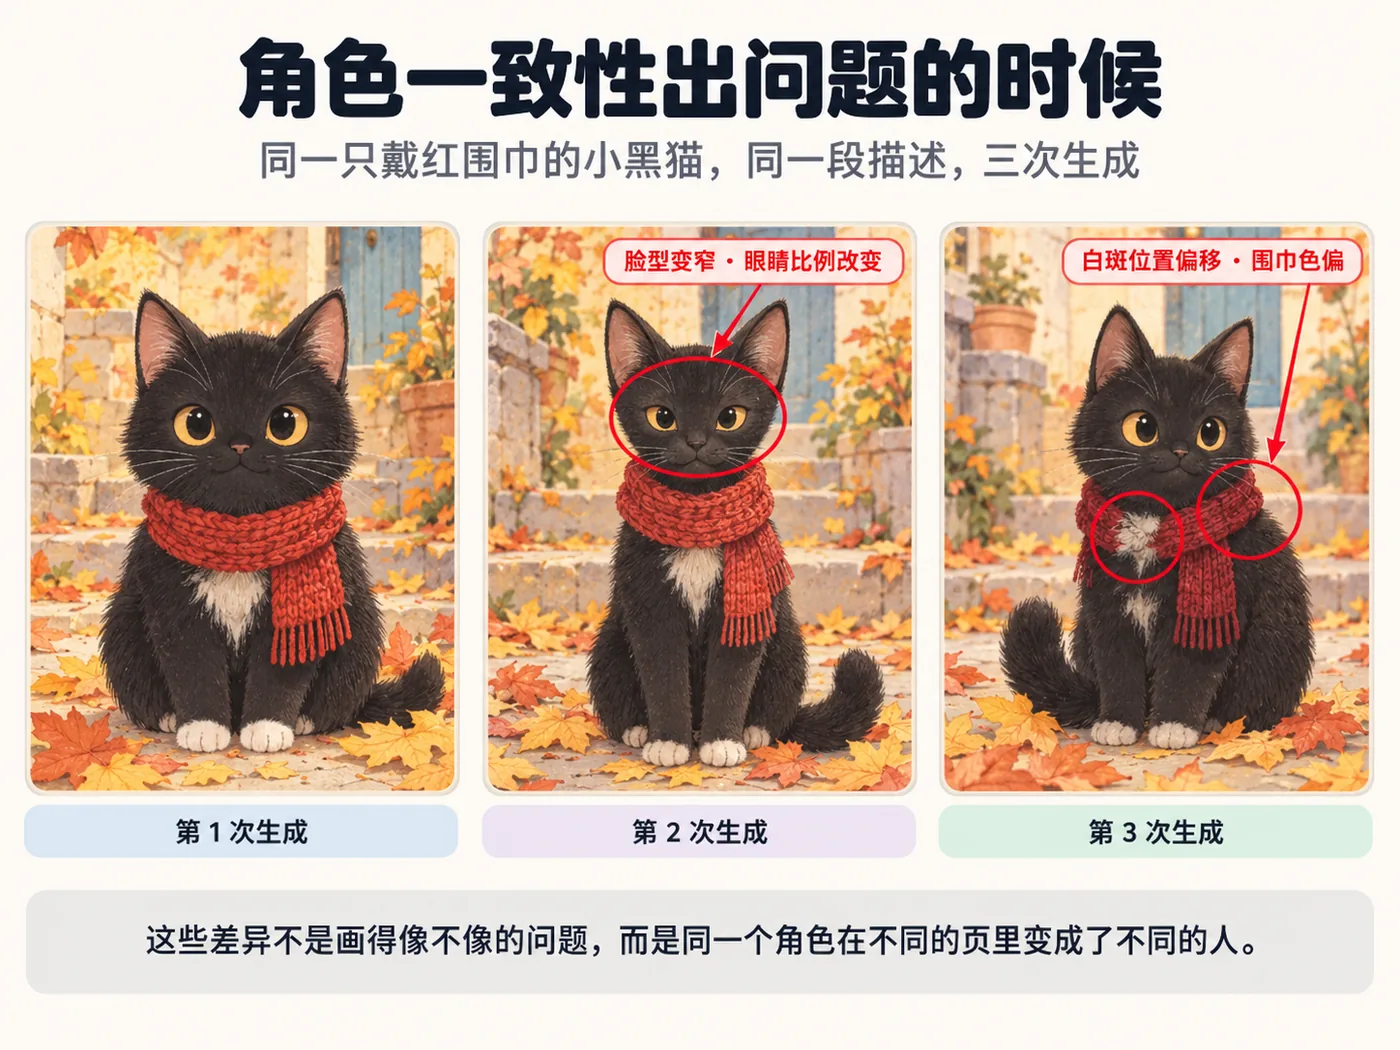
图:同一只猫、同一段描述、三次生成之间的差异。角色设定图能解决大部分问题,但不是全部
后面如果 Qwen-Image 2.1 的 LoRA 工具链成熟,我应该会试着为固定角色训练专用 LoRA。
其次是文字。
直接生成简单英文对白已经比较可用了,但真正做中文漫画或者正式出版,我还是更倾向于让模型生成气泡和画面,文字单独排版。这样可以修改,也能避免因为一个错字重新画整张图。
还有运行速度。
两三分钟一张在后台 Agent 场景里可以接受,但离实时交互还很远。一本十页左右的小绘本,如果每页都生成多个候选版本,总时间仍然不短。
另外还有一个不能忽略的问题:我这次使用的 Qwen-Image 2.1 权重说明里是 Qwen Research License。所以目前我把它当技术实验来用。涉及商业出版、收费产品或者商业服务时,需要另外核对模型当时最新的许可证和授权范围。
这也是我前几天研究「AI 生成漫画能不能卖」以后,现在会特别留意的一件事。
我下一步想做的,不只是绘本
跑通以后,我现在反而没有特别想继续批量生产几十本绘本。
我更想把这条链路继续完善。
绘本只是一个非常适合测试的任务。它同时包含长任务规划、角色一致性、多轮图片生成、参考图、文字,以及最终文件交付,正好可以把 Agent 的整条链路都跑一遍。
下一步我会继续试漫画。
《BLOOM》已经算一个很早期的版本,后面可以把多格布局、镜头语言、角色表情以及对白独立出来,做成一套固定的漫画工作流。
再往外,其实不一定是绘本。
教学插图、科普漫画、产品 Storyboard、广告分镜、游戏角色设定、连续社交媒体内容,都可以沿着差不多的结构走:
Agent
  ↓
理解任务
  ↓
准备参考素材
  ↓
选择工作流
  ↓
调用本地图像模型
  ↓
检查 / 重试
  ↓
交付成品
从这个角度看,我这次真正想留下来的也不是某个 Qwen-Image 2.1 的 ComfyUI Workflow。
模型肯定还会继续换。
我更感兴趣的是,怎样把一个本地模型包装成 Agent 真正能用的工具。
底下可以是 Qwen-Image,明天也可以换成别的图片模型;同样的思路再接上视频、TTS、音乐模型以后,一个 Agent 手里的工具会越来越多。
这次只是先让它学会了画画。
但至少现在,一整套东西已经可以在本地跑起来了。
不需要为每一张图调用一次云端 API,也不用一直坐在 ComfyUI 前面调节点。
对于我来说,这比「又出了一个画质更好的生图模型」有意思得多。
实测环境
| 项目 | 版本 / 配置 |
|---|---|
| Agent 运行时 | DeepSeek Harness 0.1.5 |
| 图片工具插件 | dsh-image-gen 0.6.10 |
| 生成后端 | ComfyUI 0.37(Desktop,--gpu-only) |
| 图像模型 | Qwen-Image 2.1(BF16) |
| 语言模型 | Qwen3.8-27B(本地) |
| 测试机器 | MacBook Pro M4 Max 128GB |
不同 GPU、不同运行时的速度和模型版本选择会有明显差异,文中的速度数据只代表我这套环境。
参考来源
- Qwen-Image-2.1 官方仓库与模型卡:https://github.com/QwenLM/Qwen-Image-2.1
- ComfyUI 格式权重(Comfy-Org):https://huggingface.co/Comfy-Org/Qwen-Image-2.1
- Comfy-Org 量化文档(int8 tensorwise 与 ConvRot):https://github.com/Comfy-Org/comfy-quants/blob/main/docs/quantization/int8_tensorwise.md
- stable-diffusion.cpp:Qwen-Image 2.1 部署说明(含 int8 convrot 文本编码器):https://github.com/leejet/stable-diffusion.cpp/blob/master/docs/qwen_image_2.1.md
- Qwen-Image-2.1 许可证说明(Qwen Research License):https://github.com/QwenLM/Qwen-Image-2.1
- 本文实测:本机 ComfyUI 服务日志(
127.0.0.1:8188)、dsh-image-gen工作流与生成脚本
数据说明:文中的速度数据来自单台 M4 Max 128GB 的一次实测,不代表 Qwen-Image 2.1 在其他硬件上的表现;Mac 上的量化版本对比结论仅适用于 MPS 后端。模型许可证信息以官方仓库当时的最新说明为准。
如果这篇文章对你有用,欢迎关注公众号「AITi智能」——每周更新。网站版同步发布:getaiti.com
订阅 · SUBSCRIBE
扫码关注公众号
文章每周更新,网站和公众号「AITi智能」同步发布。 想在微信里第一时间看到,扫码关注。
- 01 微信搜索「AITi智能」
- 02 关注并加星标
- 03 每周更新,不见不散
扫码关注 · 每周一篇