归档 / NO.009 · AI Agent · Memory · Hermes · LLM Wiki · 知识图谱
我把和 Hermes 的所有聊天,变成了一张第二大脑图谱
用了半年 Hermes,它记住的东西越来越多,我却看不见。于是我用 LLM wiki 加一张知识图谱,把它的记忆画了出来,放在家里,用手机就能翻。
本文章节 · CONTENTS 07
Agent 的记忆在长,但我一直看不见它长成了什么样。这篇讲我怎么把它画出来。
本文速览
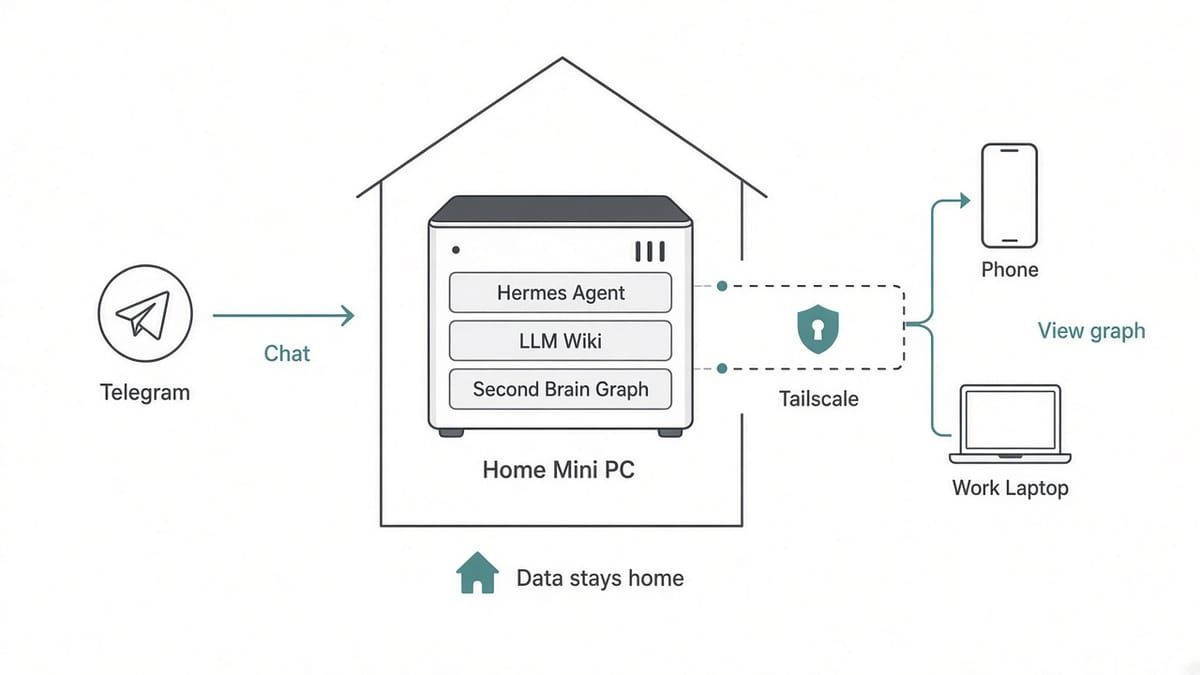
我从今年年初开始用 Hermes,聊天越积越多。我用 Karpathy 的 LLM wiki 思路,让 AI 把聊天整理成互相链接的 Markdown 页面,再写了一个小工具 second-brain-graph,把这些页面变成一张 3D 知识图谱。点开任意一个节点,可以带着它的上下文继续跟 Hermes 聊。整套东西跑在家里一台小电脑上,我用 Telegram 跟它说话,用手机和工作电脑通过 Tailscale 看图。
上一篇《一人一个 Agent》里我写过,长期存在的 Agent 得有自己的记忆。写完以后我回头看自己的 Hermes,发现一个有点尴尬的问题。
我从今年年初开始用它,到现在大概半年。每天在 Telegram 里跟它聊,聊项目、聊文章、聊看到的新东西。它确实记住了很多,有时候我随口提一句,它能接上几个月前的话题。
可它到底记住了什么,记成了什么样,我完全不知道。记忆在一个我看不见的地方慢慢变大。
能用,但心里没底。
从聊天记录到 LLM wiki
最省事的记忆方式是把聊天记录全存下来,用的时候搜一搜。这个办法我用过,问题是聊天记录本身很乱。一个想法往往散在好几次对话里,中间夹着跑题和废话,搜出来也很难看。
Karpathy 提过一个思路,叫 LLM Wiki,我后来一直在用:别堆聊天记录,让 LLM 把对话整理成一页一页的 Markdown,每页讲一个概念,页面之间用链接互相指。时间久了,就是一本 AI 帮你写、帮你维护的个人 wiki。
我在 Hermes 里就是这么做的。我的 wiki 放在 ~/wiki(目录可以配置,second-brain-graph 默认读 ~/.hermes/llm-wiki),一个概念一个文件。整理工作不用我动手,交给 AI。怎么让 OpenClaw 或者 Claude Code 自动维护知识库,我单独整理在 second-brain 这个仓库里。
wiki 解决了「记得乱」的问题。但它还是一堆文件,我能打开任意一页,却看不到整体。
为什么要做成图谱
列表和搜索有个毛病:只能找到你本来就知道要找的东西。
我想知道的往往是另一类问题:哪几个概念总是一起出现,哪个话题我其实聊了很多遍自己没意识到,两件我以为无关的事在哪里连上了。这些问题,翻文件是翻不出来的。
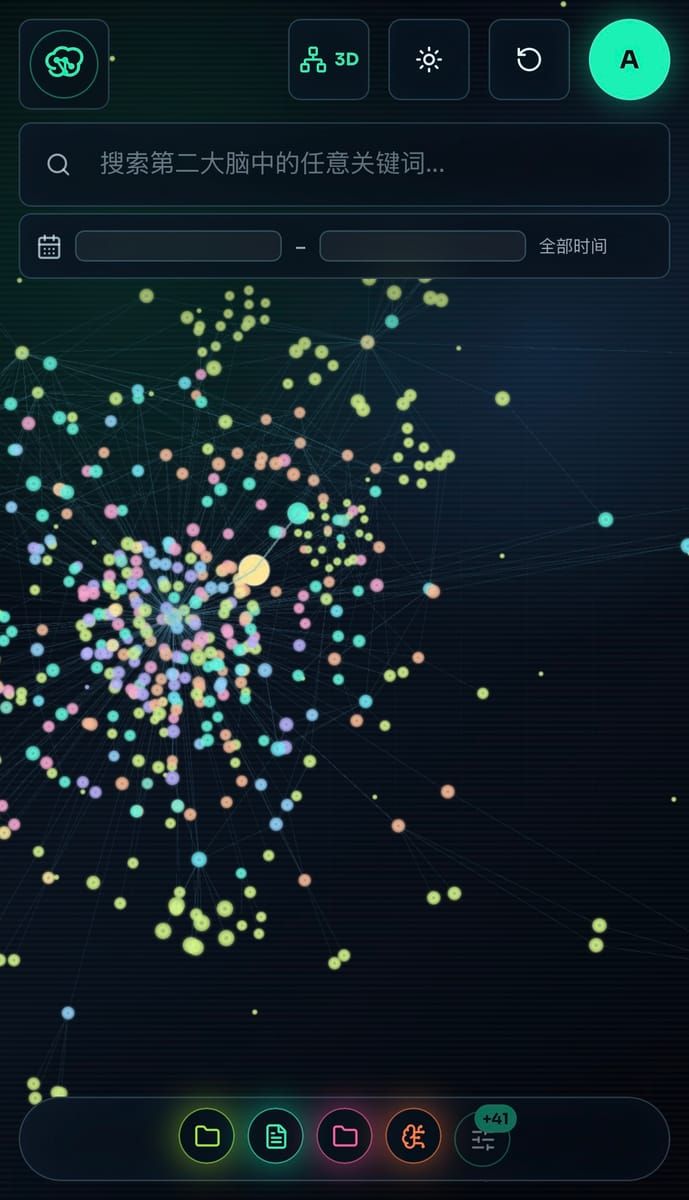
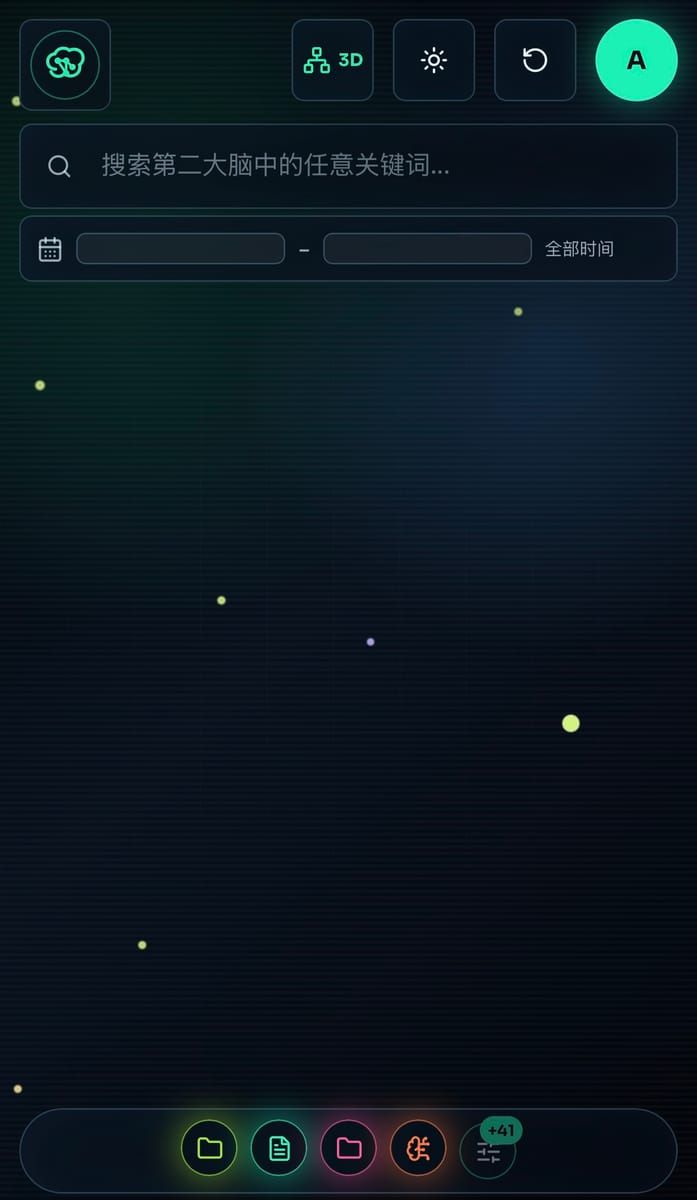
所以我写了 second-brain-graph。做法很直接:wiki 里每个概念是一个节点,页面之间的链接和显式关系是连线。打开就是一张图,可以 3D 转着看,也可以切到 2D 平铺。
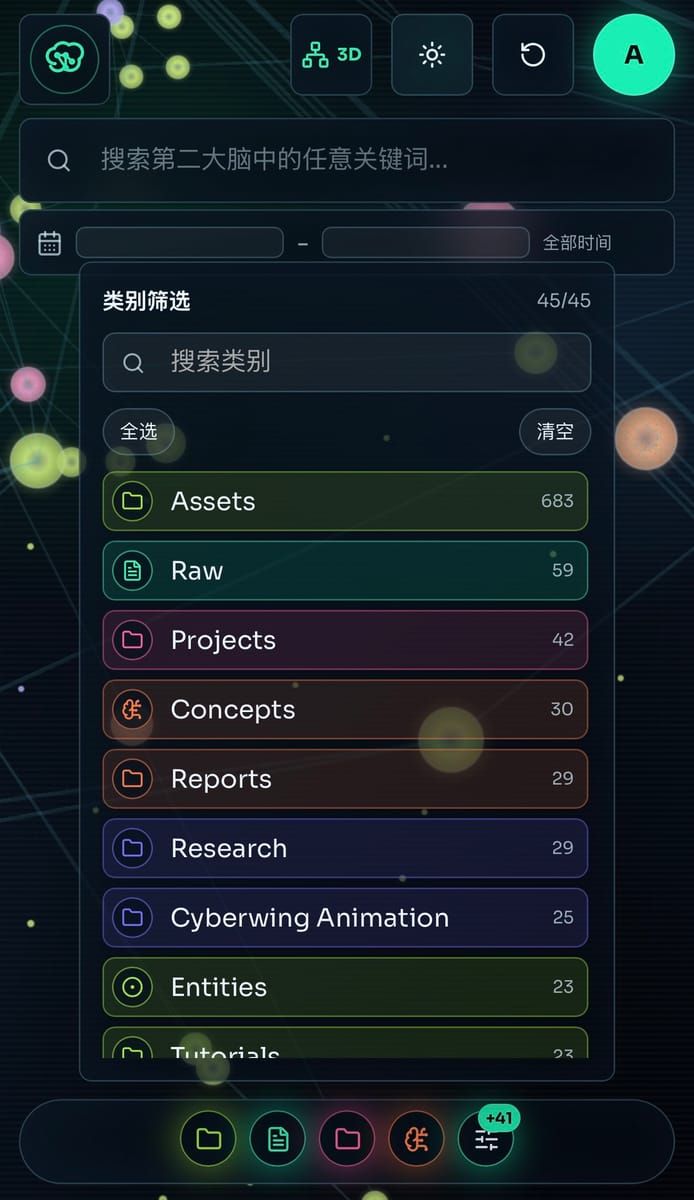
打开类别筛选能看到规模:Assets 一类就有六百多,Projects、Concepts、Research 各几十。总共四十多个类别。第一次完整打开图谱的时候,我盯着看了挺久。有些区域很密,是我反复聊的东西;有些节点孤零零挂在边上,我都忘了自己聊过。
工具本身不复杂。前端是一个单文件的 React 应用,大概两千一百行,Vite 构建,3D 用 Three.js,2D 用 Canvas。后端是一个只用 Node 内置模块的小服务,不装任何依赖。界面上有节点详情面板、分类筛选和搜索,够用就行。
在节点上深挖
光看图还不够。看到一个节点,我通常会想接着问点什么。
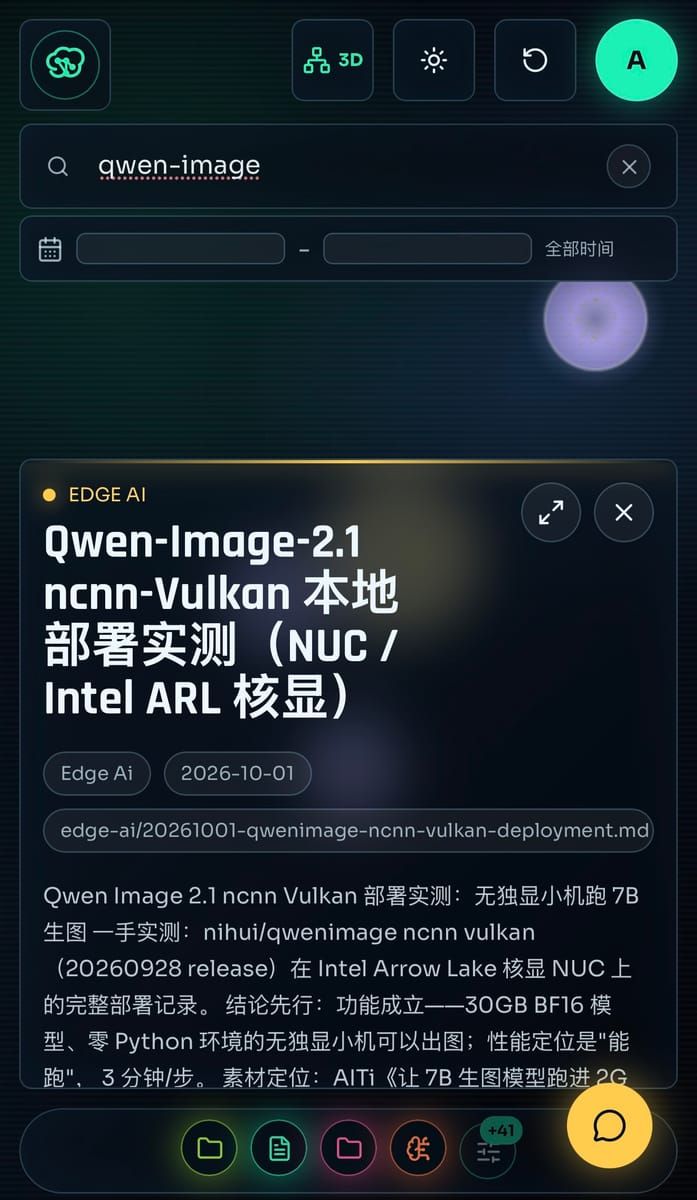
点开一个节点,右边是它的详情,下面就是对话框。这时候问 Hermes,它会带着这个节点的上下文来回答,回答是流式返回的。等于先把话题钉在一个点上,再往下挖。
每个节点的对话单独保存。下次点开同一个节点,之前聊到哪里都还在。
聊出了新东西,可以点「保存到 Wiki」,把这段洞察写回 wiki。wiki 一变,图谱跟着变,可能多出一个新节点,或者多出几条连线。
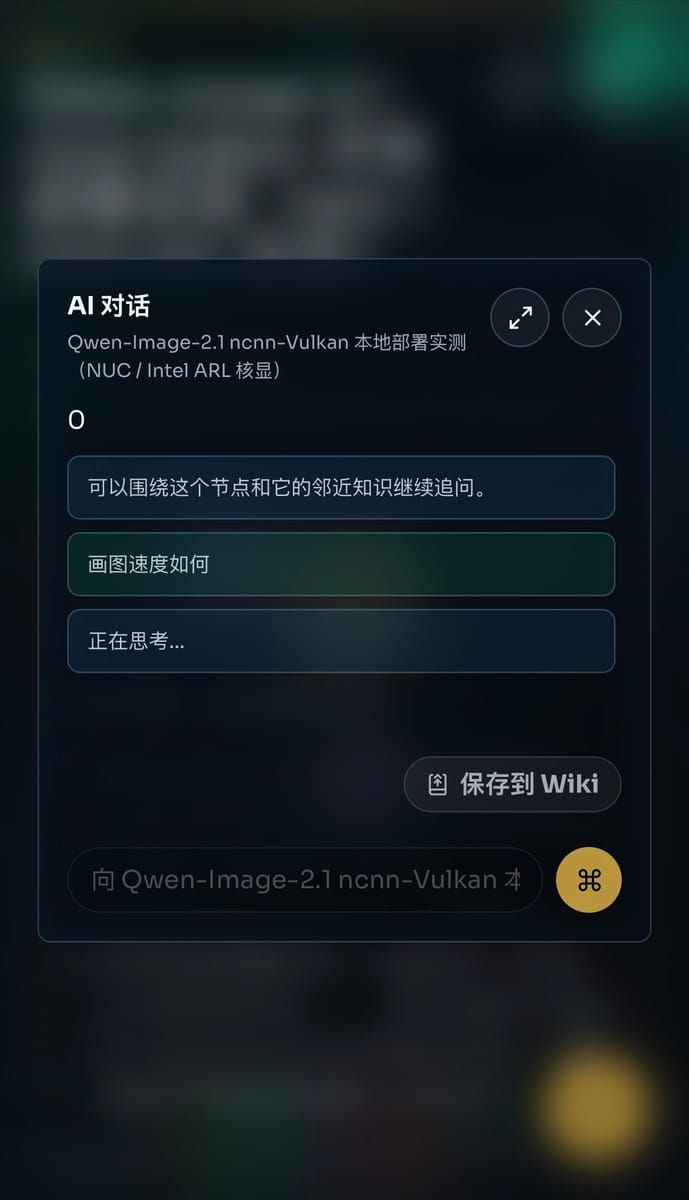
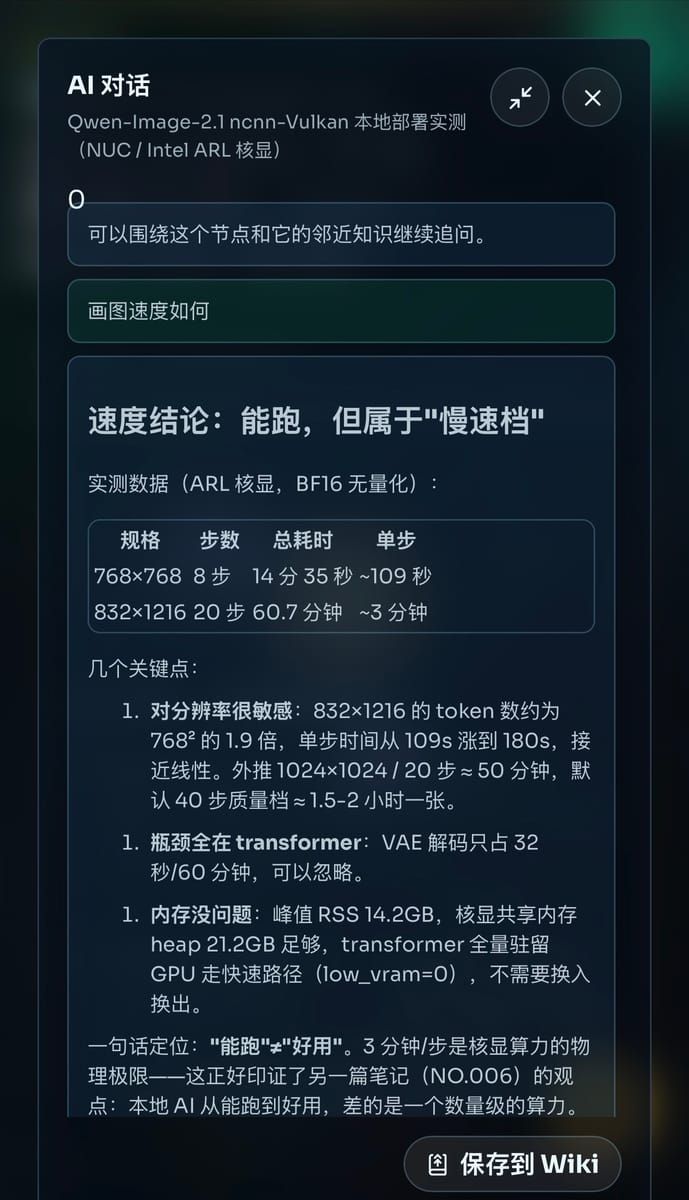
举个我自己的例子。我点开「Qwen-Image-2.1 ncnn-Vulkan 本地部署实测」这个节点,问了一句:「画图速度如何。」Hermes 带着这个节点的上下文回答:能跑,但属于慢速档——832×1216、20 步大概要一个小时,每步大约三分钟;瓶颈在 Transformer,不是显存。它还顺手接上了另一篇笔记里的判断:本地 AI 从「能跑」到「好用」,算力还差一个数量级。聊完以后,右下角点「保存到 Wiki」,这段结论就会写回 wiki,图谱跟着更新。
几个设计取舍
wiki 默认只读。 整个工具里,只有「保存到 Wiki」这一个按钮会写文件,别的操作都只读。我可以跟 Hermes 在节点上随便聊,聊错了、聊偏了都没关系,不会污染记忆。真正值得留下的,我自己点一下。
这件事我想得比较多。让 AI 自动整理记忆很方便,但让它在我不知情的时候改我的记忆,我不太放心。写回这一步,我想留在自己手里。
图谱跟着文件实时变。 服务端盯着 wiki 目录,文件一改就通过 SSE 推给页面。Hermes 在后台整理 wiki 的时候,图上的节点会自己冒出来、连起来。记忆长到哪,图就画到哪。
本地优先。 它默认只监听 127.0.0.1:3030,不对外。部署方式有几种:一个 Node 进程直接跑,Docker,或者放在 nginx 后面。另外我还做了一个离线产品模式,把 Hermes 一起打包,可以出 Windows 安装包,给不想折腾的人用。
一台家里的小电脑,三个入口
说说我自己是怎么用的。
我的 Hermes 跑在家里一台小电脑上。LLM wiki、图谱服务都在这台机器上,数据不出家门。
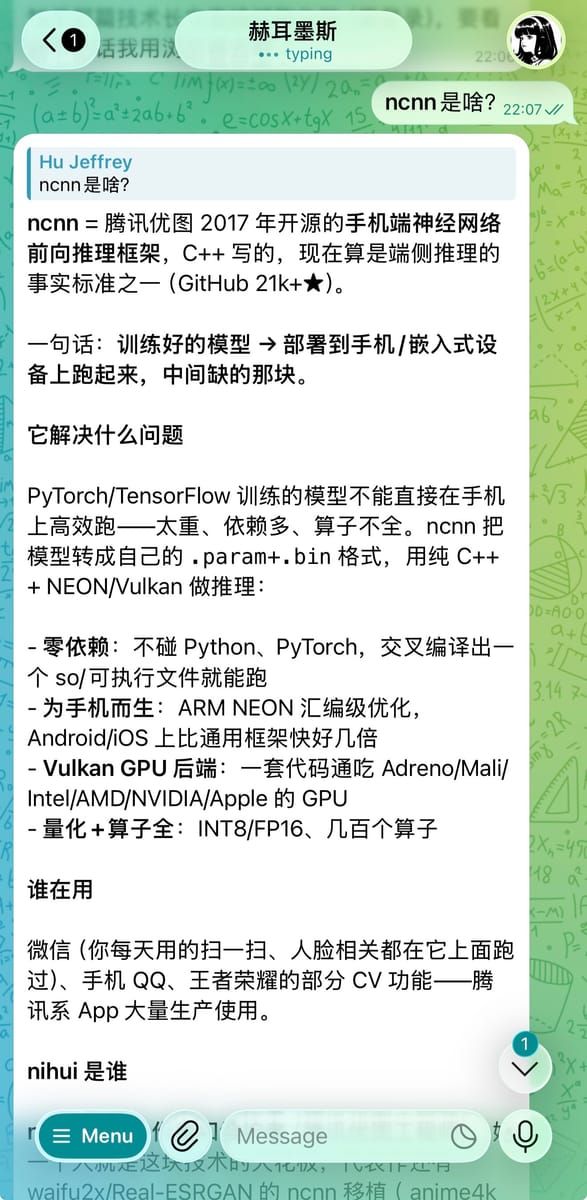
平时跟 Hermes 说话,我用 Telegram。走路、通勤、睡前,想到什么就发过去。比如随口问一句「ncnn 是啥」,它就直接讲清楚。
聊到值得留下的东西,我会让它整理成 wiki 页。那篇 Qwen-Image 本地部署实测就是这么来的:它把环境、步骤、踩过的三个坑、速度数据都写进 ~/wiki/edge-ai/ 下面,顺手更新了 index 和 log。
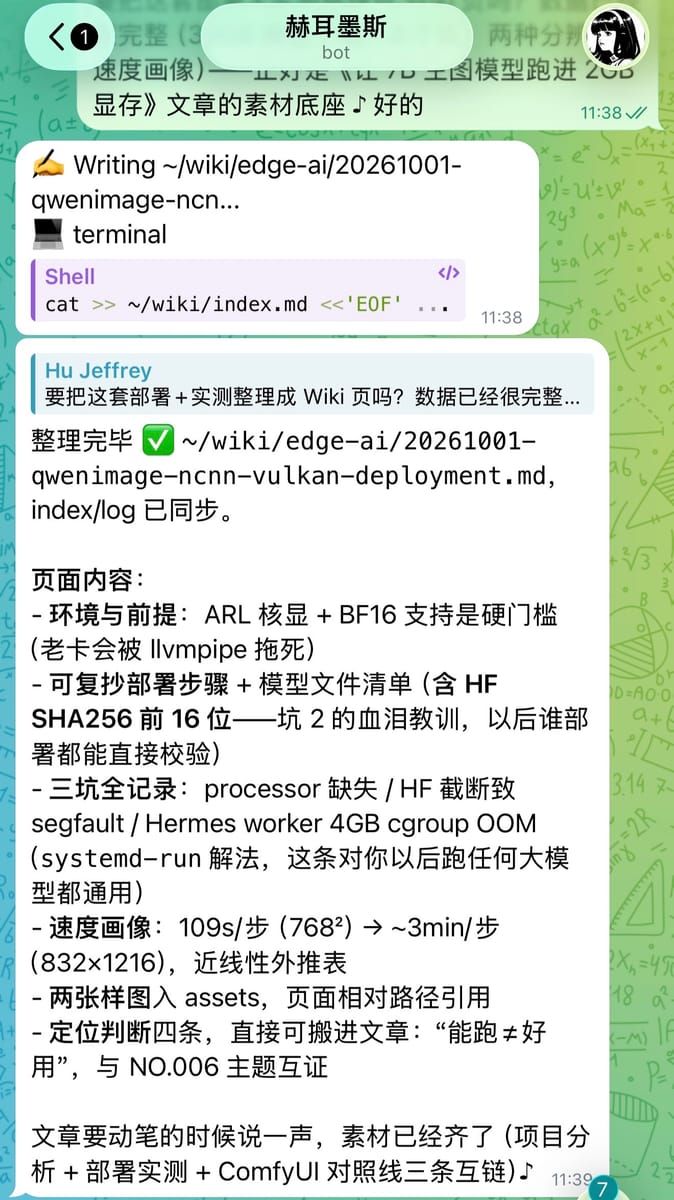
看图的时候,我用手机或者工作电脑。中间靠 Tailscale:家里那台小电脑、我的手机、工作电脑在同一个私有网络里,外面的人看不到,我自己在哪都能直接打开图谱,接着在节点上深挖。
(上面这张就是手机上打开的样子。)
我没有把图谱放到公网上,也没开任何端口。记忆是很私人的东西,我不想为了方便把它挂出去。Tailscale 不用配域名、不用开端口,只有我自己的设备能访问,正好合适。
所以这套东西的分工是:Telegram 管输入,Tailscale 管访问,数据留在家里。
上一篇我写过,本地和云端最后会混在一起。这就是一个很小的例子:Agent 住在家里,我人在哪都能用到它。
看见之后,问题也出来了
图谱画出来以后,第一个感受是踏实,第二个感受是:原来这么乱。
有些节点讲的其实是同一件事,只是换了个说法,被整理成了两页。有些概念早就过时了,项目已经结束,观点我也改了,它还挂在图上,跟别的节点连着。还有一些孤立的点,没有任何连线,不知道当初为什么会被记下来。
这些问题一直都在,只是以前看不见。
《一人一个 Agent》最后我提过,长期 Agent 的记忆不能无限往里加,得能更新、淘汰、归档。那时候这还是个想法。现在它就摆在我眼前:哪些该合并,哪些该删,哪些该放进归档,Agent 自己能判断吗?判断错了怎么办?
这是我接下来想弄清楚的事。
写在最后
模型我换过好几次,以后还会换。Telegram 和 Tailscale 也只是现在顺手的工具。
但这张图是我自己的。它长在家里那台小电脑上,记着我这半年聊过的东西。
记忆看得见,才谈得上管理它。
参考
-
Andrej Karpathy — LLM Wiki(个人知识库的 LLM 维护思路,原始 gist)
https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f -
OpenKnowledge — Karpathy LLM wiki 工作流拆解
https://openknowledge.ai/docs/workflows/karpathy-llm-wiki -
Tailscale — What is Tailscale?
https://tailscale.com/docs/concepts/what-is-tailscale -
second-brain-graph
https://github.com/zhiwehu/second-brain-graph -
second-brain
https://github.com/zhiwehu/second-brain -
AITi NO.008《一人一个 Agent》
https://www.getaiti.com/articles/008-one-agent-per-person/
订阅 · SUBSCRIBE
扫码关注公众号
文章每周更新,网站和公众号「AITi智能」同步发布。想在微信里第一时间看到,扫码关注。
- 01 微信搜索「AITi智能」
- 02 关注并加星标
- 03 每周更新,不见不散
扫码关注 · 每周一篇